

Crawler (rastreador) de mecanismo de busca
+++ term = “O que é um crawler (rastreador) de mecanismo de busca?” lastmod = “2026-10-08” title = “O que é um crawler (rastreador...
21 min de leitura
SEO
Crawlers
+4
Um spider de mecanismo de busca é um programa automatizado — também chamado de web crawler, spider bot ou simplesmente bot — que navega sistematicamente pela World Wide Web para descobrir, ler e coletar informações de páginas da web.
Documentação de crawlers do Google explica as categorias de crawlers e fetchers usadas pelo Google. Use essa documentação ao verificar como um crawler específico do Google acessa um site de afiliados.
Nesta página
Um spider de mecanismo de busca é um programa automatizado — também chamado de web crawler, spider bot ou simplesmente um bot — que navega sistematicamente pela World Wide Web para descobrir, ler e coletar informações de páginas da web. Os dados que um spider coleta são enviados de volta para um mecanismo de busca, que os organiza em um enorme banco de dados chamado índice. Quando alguém faz uma consulta de pesquisa, o mecanismo extrai resultados relevantes desse índice, não da web ao vivo.
O termo “spider” vem da forma como esses programas navegam na web: eles seguem hiperlinks de página em página, muito parecido com uma aranha se movendo pelos fios de sua teia. O primeiro crawler conhecido, WebCrawler, lançado em 1994, ajudou a popularizar a metáfora que pegou.
O Google usa o Googlebot, o Bing usa o Bingbot, e ambos são spiders que executam a mesma função principal.

Configure o rastreamento avançado em minutos. Não é necessário cartão de crédito.
Entender o processo de rastreamento ajuda os proprietários de sites a tomar melhores decisões sobre estrutura do site, prioridade de páginas e SEO técnico.
Cada spider começa com uma lista de endereços web conhecidos chamados URLs sementes. Elas podem vir de páginas rastreadas anteriormente, sitemaps XML enviados ou links descobertos durante rastreamentos anteriores. A partir de cada semente, o spider baixa a página e extrai cada hiperlink que ela contém. Esses links formam uma fila — às vezes chamada de fronteira de rastreamento — de páginas a visitar em seguida.
Quando um spider chega a uma página, ele faz três coisas:
User-Agent (ex.: Googlebot/2.1).O processo funciona em um ciclo contínuo:
Um spider também verifica o arquivo robots.txt antes de rastrear qualquer página em um domínio. Se o arquivo desautorizar um caminho, um spider bem-comportado o ignorará. Spiders também obedecem a meta robots tags e cabeçalhos HTTP X-Robots-Tag que os instruem a não indexar uma página ou a não seguir seus links.
Cada grande mecanismo de busca opera seu próprio spider. Aqui estão os que têm mais probabilidade de visitar seu site:
| Nome do Spider | Mecanismo de Busca | Token User-Agent |
|---|---|---|
| Googlebot | Googlebot | |
| Bingbot | Bing | Bingbot |
| Slurp Bot | Yahoo (alimentado pelo Bing) | Slurp |
| DuckDuckBot | DuckDuckGo | DuckDuckBot |
| Baiduspider | Baidu (China) | Baiduspider |
| Yandex Bot | Yandex (Rússia) | YandexBot |
| Applebot | Apple (Siri, Spotlight) | Applebot |
O Googlebot existe em duas variantes: um crawler de desktop que simula um navegador de desktop e um crawler móvel que simula um smartphone. Desde que o Google mudou para a indexação mobile-first, o Googlebot móvel é o crawler principal para a grande maioria dos sites.
O Bingbot alimenta o índice do Bing e também fornece resultados para o Yahoo e outros parceiros de sindicação. O DuckDuckBot rastreia para o DuckDuckGo, que complementa seu próprio índice com resultados do Bing. O Baiduspider e o Yandex Bot atendem aos mercados chinês e russo, respectivamente, e vale a pena permiti-los se você tiver audiências nessas regiões.
Seja o primeiro a saber sobre novos recursos e atualizações do produto.
Os spiders de mecanismo de busca podem ver tudo o seguinte quando visitam uma página:
Spiders não “veem” as páginas da mesma forma que um humano. Conteúdo incorporado em imagens sem texto alternativo, texto renderizado dentro de JavaScript complexo que não executa, e conteúdo atrás de muros de login ou paywalls é invisível para a maioria dos spiders. Elementos interativos como formulários, menus suspensos e conteúdo de rolagem infinita que exigem cliques do usuário também podem ser perdidos, a menos que o site use renderização adequada do lado do servidor ou técnicas de renderização dinâmica.
Orçamento de rastreamento (crawl budget) é o número de páginas que um spider de mecanismo de busca irá rastrear em seu site dentro de um determinado período. O Google determina o orçamento de rastreamento com base em dois fatores:
Para sites grandes — catálogos de e-commerce, editores de notícias ou sites de afiliados com milhares de páginas de produtos — o orçamento de rastreamento é importante. Se os spiders gastam tempo em URLs de baixo valor (parâmetros de filtro, IDs de sessão, páginas duplicadas), eles podem não chegar ao seu conteúdo importante antes que a janela de rastreamento se feche.
Você tem três ferramentas principais para orientar o comportamento dos spiders.
Um arquivo robots.txt, colocado na raiz do seu domínio, informa aos spiders quais partes do seu site eles podem ou não visitar. Ele usa uma sintaxe simples:
User-agent: *
Disallow: /admin/
Disallow: /search/
/admin/ e /search/. Você pode segmentar spiders específicos usando seu token de user-agent:User-agent: Googlebot
Disallow: /private/
Para controle no nível da página, use a meta robots tag no <head> do HTML:
<meta name="robots" content="noindex, nofollow">
X-Robots-Tag), o que é útil para arquivos não HTML, como PDFs.Um sitemap XML lista as URLs que você deseja que os spiders priorizem. Envie-o através do Google Search Console ou do Bing Webmaster Tools. Um sitemap não garante o rastreamento, mas ajuda os spiders a descobrir páginas novas e atualizadas mais rapidamente — especialmente em sites com arquitetura profunda ou links internos limitados.
Os termos são frequentemente confundidos, mas descrevem propósitos diferentes:
| Aspecto | Web Crawler (Spider) | Web Scraper |
|---|---|---|
| Propósito | Descobrir e indexar páginas para busca | Extrair dados específicos de páginas |
| Operador | Mecanismos de busca (Google, Bing) | Indivíduos, empresas, pesquisadores |
| Escopo | Amplo — toda a web acessível | Direcionado — sites ou pontos de dados específicos |
| Saída | Um índice pesquisável | Dados estruturados (CSV, banco de dados, API) |
| Respeita robots.txt | Sim (os legítimos) | Varia; muitos scrapers ignoram |
Um spider constrói o mapa; um scraper explora o território. Ambos são automatizados, mas servem a objetivos fundamentalmente diferentes. Algumas ferramentas, como o Screaming Frog SEO Spider, borram a linha — eles rastreiam como um spider, mas são usados para auditoria de sites, não para indexação de busca.
Não inerentemente. Spiders legítimos de mecanismos de busca são benéficos — sem eles, seu site não apareceria nos resultados de busca. No entanto, nem todos os bots são amigáveis.
Sinais de atividade prejudicial de bots incluem:
O GPTBot da OpenAI é um web crawler usado para coletar dados de treinamento para modelos de IA. Não é um spider de mecanismo de busca — ele não alimenta um índice de busca público.
User-agent: GPTBot
Disallow: /
Se você está preocupado com privacidade, o DuckDuckGo e o Brave Search são os dois principais mecanismos de busca que não rastreiam usuários nem criam perfis pessoais. Ambos operam seus próprios spiders (DuckDuckBot e o crawler do Brave) e complementam seus índices com resultados de outras fontes. Eles dependem de palavras-chave contextuais em vez do histórico do usuário para classificar resultados, o que significa que o SEO on-page do seu site é ainda mais importante para a visibilidade nessas plataformas.
Os spiders de mecanismo de busca afetam diretamente todos os papéis no ecossistema de marketing de afiliados.
Suas páginas de destino do programa de afiliados, páginas de termos e conteúdo promocional devem ser rastreáveis e indexáveis. Se os spiders não conseguirem alcançar as informações do seu programa, potenciais afiliados pesquisando por “[sua marca] programa de afiliados” podem não encontrá-lo organicamente. Etapas principais:
Cada review de produto, artigo de comparação e guia que você publica depende de ser encontrado através da busca — e isso significa ser rastreado e indexado. Spiders são os guardiões. Melhores práticas:
lastmod em seu sitemap pode fazer com que os spiders revisitem suas páginas mais cedo.Entender o comportamento dos spiders ajuda você a apoiar melhor seus afiliados:
site:) e se eles não estão bloqueando spiders inadvertidamente.Descubra como entender os spiders da web pode ajudar você a otimizar seu site para melhores classificações de busca e aumento da receita de afiliados.
+++ term = “O que é um crawler (rastreador) de mecanismo de busca?” lastmod = “2026-10-08” title = “O que é um crawler (rastreador...
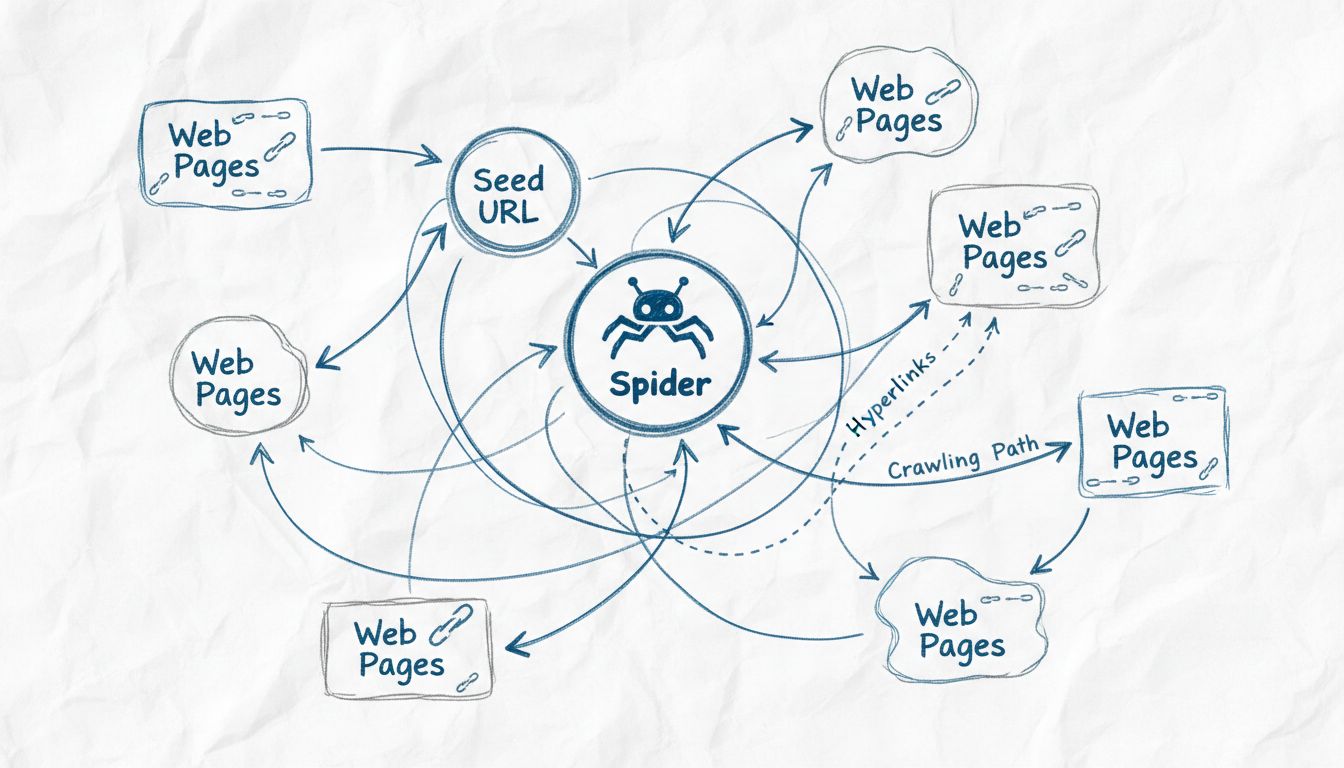
Descubra por que os rastreadores da web são chamados de spiders, como funcionam e seu papel fundamental na indexação dos mecanismos de busca. Conheça os mecanis...
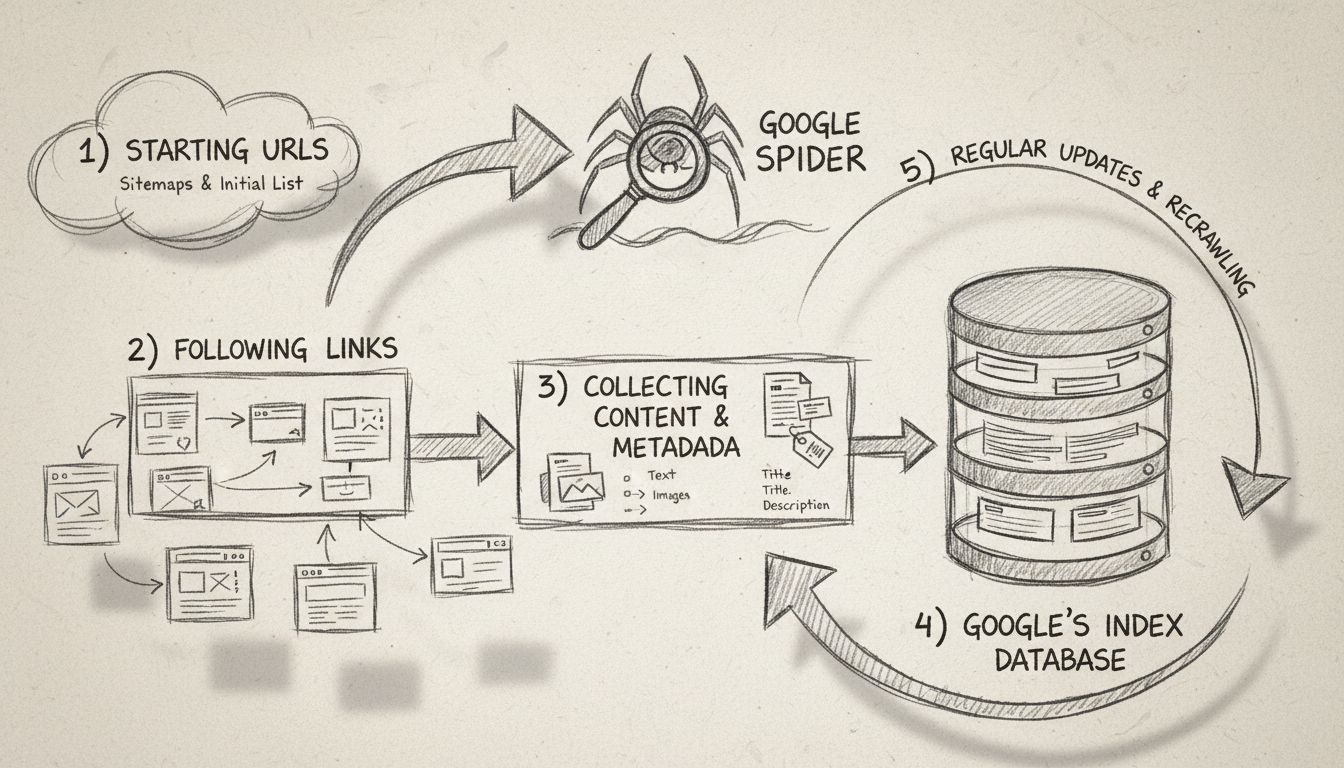
Descubra o que é o Google Spider (Googlebot), como ele rastreia e indexa sites e por que é essencial para o SEO. Aprenda como otimizar seu site para um melhor r...
Junte-se à nossa comunidade de clientes satisfeitos e forneça excelente suporte ao cliente com o Post Affiliate Pro.
See our privacy policy.