


O que é um spider de mecanismo de busca?
Um spider de mecanismo de busca é um bot automatizado que rastreia páginas da web para indexar conteúdo em mecanismos como Google e Bing. Saiba como eles funcio...
12 min de leitura
SEO
DigitalMarketing
+3
+++ term = “O que é um crawler (rastreador) de mecanismo de busca?” lastmod = “2026-10-08” title = “O que é um crawler (rastreador) de mecanismo de busca?” keywords = [ “ranking em mecanismos de busca”, “mecanismo de busca”, “ranking de mecanismos”, “otimização para mecanismos de busca”, “papel na busca”, “rastreadores”, “busca”, “mecanismo” ] url = “/glossario-marketing-afiliados/rastreadores/” aliases = [ “/affiliate-marketing-glossary/crawlers/” ] description = “Aprenda como os crawlers de mecanismos de busca descobrem e indexam páginas da web e por que isso é importante para SEO.” date = “2024-11-07 11:14:13” image = "" shortDescription = “Um crawler de mecanismo de busca é um programa de software automatizado — também chamado de bot, spider ou spiderbot — que navega sistematicamente pela World Wide Web, baixa o conteúdo das páginas e segue hiperlinks para descobrir URLs novos ou atualizados.” tags = [ “SEO”, “Crawlers”, “Indexing”, “AffiliateMarketing”, “SearchEngines”, “TechnicalSEO” ] categories = [ “Glossary” ] showCTA = true ctaHeading = “Otimize Seu Site para Mecanismos de Busca” ctaDescription = “Saiba como entender e otimizar para crawlers pode aumentar a visibilidade do seu site e seu ranking nos mecanismos de busca.” ctaPrimaryText = “Obtenha Dicas de SEO” ctaPrimaryURL = “/blog/” ctaSecondaryText = “Experimente o Post Affiliate Pro” ctaSecondaryURL = “/trial/”
[[faq]] question = “Você pode me dar um exemplo de um web crawler?” answer = “O Googlebot é o exemplo mais conhecido. É o principal crawler web do Google, responsável por descobrir e indexar bilhões de páginas na web. Outros exemplos incluem Bingbot (Microsoft Bing), DuckDuckBot (DuckDuckGo), YandexBot (Yandex) e Baiduspider (Baidu). No lado da IA, o GPTBot da OpenAI e o Claude-Web da Anthropic são crawlers que coletam dados publicamente disponíveis para treinamento de modelos.”
[[faq]] question = “O que é orçamento de rastreamento (crawl budget) e por que ele é importante?” answer = “Orçamento de rastreamento é o número de páginas que um mecanismo de busca irá rastrear em um site dentro de um determinado período. Ele é determinado pelo limite de taxa de rastreamento (o quão rápido o mecanismo pode buscar sem prejudicar o desempenho) e pela demanda de rastreamento (o quanto o mecanismo deseja rastrear com base em popularidade e atualização). Sites grandes com milhares de páginas precisam gerenciar o orçamento de rastreamento com cuidado — desperdiçá-lo em conteúdo duplicado, URLs de navegação facetada ou páginas de erro significa que páginas de alto valor podem ficar sem visitação.”
[[faq]] question = “Como verifico se meu site foi rastreado?” answer = “Os métodos mais confiáveis são:
[[faq]] question = “Posso bloquear um crawler sem afetar meu SEO?” answer = “Sim. Use diretivas robots.txt direcionadas a user-agents específicos. Por exemplo, bloquear o GPTBot não afeta o Googlebot, Bingbot ou qualquer outro crawler de busca. O segredo é a especificidade — use User-agent: GPTBot (e não User-agent: *) quando quiser bloquear um único crawler enquanto mantém o acesso dos mecanismos de busca intacto. Sempre teste as alterações no robots.txt no Google Search Console antes de publicá-las.”
[[faq]] question = “Como os crawlers são usados por empresas de IA como a OpenAI?” answer = “Empresas de IA implantam crawlers como o GPTBot para coletar dados web publicamente disponíveis para treinar grandes modelos de linguagem e permitir recuperação de informações ao vivo. Esses crawlers seguem os mesmos mecanismos básicos dos crawlers de mecanismos de busca — buscando páginas, seguindo links e respeitando robots.txt — mas seu propósito é o treinamento de modelos, não a indexação de busca.”
[[lnks]] text = “indexação mobile-first” path = “/blog/mobile-friendliness-affiliate-marketing/” title = “Por que a compatibilidade com dispositivos móveis é um fator real de ranking e receita no marketing de afiliados, desde Core Web Vitals até design responsivo, e como testar e corrigir seu site afiliado para dispositivos móveis.”
[[lnks]] text = “páginas web que os crawlers” path = “/faq/why-are-web-crawlers-called-spiders/” title = “Saiba por que os web crawlers são chamados de spiders, como funcionam e seu papel crítico na indexação de mecanismos de busca. Descubra os mecanismos técnicos por trás do web crawling em 2025.”
[[lnks]] text = “orçamento para cada” path = “/blog/optimize-affiliate-marketing-budget/” title = “seis estratégias acionáveis para otimizar seu orçamento de marketing de afiliados, incluindo o uso de mídias sociais, colaboração com influenciadores de nicho”
[[lnks]] text = “Conteúdo novo e relevante” path = “/faq/keep-content-fresh-engaging/” title = “Descubra estratégias eficazes para manter seu conteúdo novo e envolvente. Saiba mais sobre formatos de conteúdo, análise de dados, engajamento de audiência e técnicas de escrita profissional para manter o interesse do público e impulsionar o sucesso no marketing de afiliados.”
[[lnks]] text = “profissionais de marketing de afiliados” path = “/faq/what-makes-affiliate-marketing-content-rank-well/” title = “Descubra os fatores essenciais que fazem o conteúdo de marketing de afiliados ter um bom ranking nos mecanismos de busca. Aprenda estratégias comprovadas de SEO, técnicas de otimização de conteúdo e melhores práticas para aumentar a visibilidade e as conversões do seu site afiliado.”
[[lnks]] text = “Otimização de Palavras-chave” path = “/faq/how-to-do-on-page-seo/” title = “Aprenda como otimizar o SEO on-page com tags de título, meta descrições, cabeçalhos, palavras-chave e estratégias de conteúdo. Domine a otimização técnica on-page para melhorar rankings de busca com o guia completo do PostAffiliatePro.”
[[lnks]] text = “Profissionais de marketing de afiliados” path = “/blog/top-keyword-research-tools-for-affiliate-marketers/” title = “Quais ferramentas de pesquisa de palavras-chave os profissionais de marketing de afiliados devem usar para fazer seu conteúdo rankear mais alto no Google? Leia este artigo para descobrir!”
[[lnks]] text = “Links de Afiliados Geralmente” path = “/affiliate-marketing-glossary/seo-affiliates/” title = “Afiliados de SEO, também conhecidos como afiliados de busca, ajudam você a melhorar o ranking do seu site na página de resultados de busca. Descubra como afiliados de SEO usam estratégias especializadas para gerar tráfego orgânico e impulsionar o sucesso no marketing de afiliados.”
[[lnks]] text = “Web crawlers” path = “/faq/how-do-web-crawlers-work/” title = “Aprenda como os web crawlers funcionam, desde URLs semente até a indexação. Entenda o processo técnico, tipos de crawlers, regras de robots.txt e como os crawlers impactam SEO e marketing de afiliados.”
[[lnks]] text = “afetam o SEO” path = “/faq/why-are-sitemaps-important/” title = “Saiba por que os sitemaps são cruciais para o sucesso em SEO. Descubra como sitemaps XML e HTML melhoram a rastreabilidade, indexação e visibilidade nos mecanismos de busca para seu site.”
[[lnks]] text = “mecanismos de busca” path = “/faq/how-to-identify-search-engine-crawlers/” title = “Aprenda como identificar crawlers de mecanismos de busca usando strings user-agent, endereços IP, padrões de requisição e análise comportamental. Guia essencial para webmasters e desenvolvedores.”
[[lnks]] text = “cruciais para a busca” path = “/faq/what-is-google-spider/” title = “Saiba o que é o Google Spider (Googlebot), como ele rastreia e indexa sites, e por que é essencial para SEO. Descubra como otimizar seu site para um melhor rastreamento.” +++ Um crawler de mecanismo de busca (rastreador) é um programa de software automatizado — também chamado de bot, spider ou spiderbot — que navega sistematicamente pela World Wide Web, baixa o conteúdo das páginas e segue hiperlinks para descobrir URLs novos ou atualizados. Sua função principal é alimentar o índice de um mecanismo de busca com dados atualizados para que, quando alguém digitar uma consulta, o mecanismo possa retornar resultados relevantes e atuais. Sem crawlers, um mecanismo de busca não tem como saber que uma página existe.
O crawler em si não classifica nada. Ele descobre e entrega o que encontra — texto, links, metadados, imagens — para um sistema separado de indexação e classificação. Rastreamento, indexação e classificação são três etapas distintas. Uma página pode ser rastreada e ainda assim nunca aparecer nos resultados de busca se não atender aos limites de qualidade do mecanismo durante a indexação.
A documentação de crawlers do Google distingue seus crawlers comuns, crawlers de casos especiais e extratores acionados pelo usuário. Verifique a identidade e o comportamento documentados do crawler relevante ao investigar problemas de acesso.
Nesta página
Um web crawler opera em um ciclo contínuo construído em torno de algumas etapas principais. Entender essas etapas ajuda os proprietários de sites a diagnosticar por que as páginas podem não aparecer nos resultados de busca — o problema geralmente está na fase de rastreamento, muito antes de a classificação ser sequer considerada.
Todo crawler começa com um conjunto de URLs conhecidas chamadas URLs semente. Elas podem vir de páginas previamente rastreadas, sitemaps enviados ou pontos de partida selecionados manualmente. O crawler baixa cada página semente, extrai todos os hiperlinks que encontra e adiciona qualquer link que não tenha visto antes a uma fila em execução chamada fronteira de rastreamento.
O ciclo então se repete:
Este ciclo nunca termina de verdade. A web muda constantemente e novas páginas surgem a cada segundo, então um crawler simplesmente processa o que está na fila, revisitando páginas antigas para verificar alterações e adicionando URLs recém-descobertas.
Quando um crawler busca uma página, ele renderiza o conteúdo — lê o HTML, executa JavaScript quando possível e extrai o texto, imagens, metadados e dados estruturados. Em seguida, baixa essas informações e as envia para o indexador do mecanismo de busca.
Nem todo crawler lida com JavaScript igualmente bem. O Googlebot renderiza JavaScript e aguarda conteúdo carregado dinamicamente, mas crawlers de mecanismos de busca menores podem apenas ler HTML estático. É por isso que sites construídos inteiramente com frameworks JavaScript do lado do cliente podem ficar invisíveis para alguns mecanismos de busca, a menos que a renderização do lado do servidor esteja implementada.
Os crawlers descobrem novas páginas através de dois canais principais:

Configure o rastreamento avançado em minutos. Não é necessário cartão de crédito.
Os crawlers não tratam todas as páginas igualmente. Eles operam sob um conjunto de políticas de rastreamento que determinam quais páginas visitar, em que ordem e com que frequência retornar.
Um crawler deve decidir quais URLs priorizar em sua fronteira de rastreamento. Sinais comuns incluem:
A frequência com que um crawler retorna a uma página depende da frequência com que essa página muda. A página inicial de um site de notícias pode ser rastreada a cada poucos minutos. Uma página estática “Sobre Nós” pode ser revisitada a cada poucos meses. Os webmasters podem sinalizar a frequência de alteração através de tags <changefreq> no sitemap XML, embora os mecanismos de busca tratem essas indicações como sugestões, não como comandos.
Os crawlers são programados para evitar sobrecarregar os servidores web. Eles respeitam um limite de taxa de rastreamento — o número máximo de requisições que enviarão a um único site em um determinado período. Se um servidor responder com erros HTTP como 500 ou 503, o crawler recua para não agravar o problema. Isso faz parte do que torna o rastreamento em grande escala um verdadeiro desafio de engenharia.
O arquivo robots.txt é um documento de texto simples colocado na raiz de um domínio que informa aos crawlers quais URLs eles podem ou não solicitar. É a ferramenta mais importante para gerenciar o acesso de crawlers. Uma entrada no robots.txt pode ser assim:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/, mas permitir tudo em /public/. Outros crawlers verificam o mesmo arquivo e seguem suas próprias diretivas User-agent. Vale notar que o robots.txt é um protocolo voluntário — crawlers bem-comportados o obedecem, mas bots maliciosos podem ignorá-lo completamente.Orçamento de rastreamento é o número de páginas que um mecanismo de busca irá rastrear em um site dentro de um determinado período de tempo. É determinado por dois fatores:
Para sites pequenos, o orçamento de rastreamento raramente é uma preocupação. Para grandes plataformas de e-commerce ou sites de conteúdo com milhões de URLs, gerenciar o orçamento de rastreamento se torna essencial — rastreamentos desperdiçados em conteúdo duplicado, parâmetros de navegação facetada ou páginas de baixo valor significam menos recursos para as páginas que realmente importam.
Cada grande mecanismo de busca opera seu próprio crawler com uma string de user-agent distinta — um identificador que o bot envia junto com cada requisição HTTP para que os servidores saibam qual crawler está visitando.
| Mecanismo de Busca | Nome do Crawler | Identificador User-Agent | Finalidade |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Rastreia e indexa páginas web para o Google Search e outros serviços do Google | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Rastreia e indexa páginas para o Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Rastreia páginas para os resultados de busca do DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Rastreia páginas para o Yandex Search (dominante na Rússia) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Rastreia páginas para o Baidu Search (dominante na China) |
| Apple | Applebot | Applebot/1.0 | Rastreia páginas para o Spotlight Search e sugestões da Siri |
O Google também opera crawlers especializados para diferentes tipos de conteúdo — Googlebot Image rastreia imagens, Googlebot Video lida com conteúdo de vídeo, Googlebot News tem como alvo artigos de notícias e o AdsBot verifica a qualidade das páginas de destino para o Google Ads.
Seja o primeiro a saber sobre novos recursos e atualizações do produto.
Identificar se um visitante é realmente o Googlebot requer mais do que verificar uma string user-agent, já que essas strings podem ser falsificadas. Para verificar um crawler do Google:
Googlebot.googlebot.com ou google.com.O Google fornece documentação oficial listando suas faixas de IP em google.com/bot.html. Qualquer visitante que alegue ser o Googlebot e falhe nessas etapas de verificação é um bot falsificado e deve ser tratado como suspeito.
Sim — mas com limites. Grandes mecanismos de busca operam crawlers dedicados para conteúdo não textual:
VideoObject para entender título, descrição, miniatura e duração.No entanto, os crawlers não podem “ver” imagens como um humano ou “assistir” a um vídeo. Eles dependem inteiramente de sinais textuais — nomes de arquivo, atributos alt, legendas, texto corporal ao redor e dados estruturados — para determinar a relevância. Conteúdo bloqueado por telas de login, paywalls ou incorporado em players JavaScript complexos pode não ser rastreado.
Esses termos são frequentemente usados de forma intercambiável, mas descrevem coisas diferentes:
| Aspecto | Web Crawler | Web Scraper |
|---|---|---|
| Finalidade | Descobrir e indexar URLs em toda a web | Extrair dados específicos de páginas segmentadas |
| Escopo | Amplo — segue links por toda parte | Restrito — tem como alvo URLs ou domínios conhecidos |
| Saída | Alimenta um índice de busca | Produz dados estruturados (CSV, banco de dados, planilha) |
| Operador típico | Mecanismos de busca (Google, Bing) | Empresas, pesquisadores, analistas de dados |
| Respeita robots.txt | Sim (crawlers legítimos) | Varia — muitos scrapers ignoram |
| Exemplos | Googlebot, Bingbot | Ferramentas de monitoramento de preços, scrapers de geração de leads, coletores de dados para treinamento de IA |
Os mecanismos de busca encontram novas páginas através de vários canais:
O caminho mais rápido para uma nova página ser rastreada é enviar sua URL diretamente através do Search Console e garantir que ela tenha link de uma página já indexada no mesmo site.
Não há uma programação fixa. A frequência de revisita depende de:
Os proprietários de sites podem influenciar a frequência de revisita publicando conteúdo regularmente, mantendo tempos de resposta rápidos do servidor e enviando sitemaps atualizados. Mas, em última análise, o crawler decide sua própria programação com base nos sinais que observa.
Os crawlers geralmente não conseguem acessar:
Um crawler vê apenas o que está publicamente acessível e linkado. Se uma página requer autenticação ou interação do usuário para ser renderizada, ela é efetivamente invisível para os mecanismos de busca — a menos que o proprietário do site conceda acesso explicitamente ou forneça um caminho alternativo, como um sitemap listando a URL combinado com dados estruturados que descrevem o conteúdo.
Construir um crawler que funcione para algumas centenas de páginas é direto. Construir um que funcione para bilhões é um problema completamente diferente. Pontos de falha comuns incluem:
Para a maioria das empresas, operar um web crawler em grande escala não é prático sem infraestrutura gerenciada. A decisão geralmente se resume a usar uma ferramenta existente em vez de construir do zero.
Nos Estados Unidos, o web crawling de páginas publicamente acessíveis é geralmente legal. Várias decisões judiciais — incluindo *hiQ Labs v.
No entanto, a legalidade depende de vários fatores:
A distinção entre rastreamento para indexação de busca (amplamente aceito) e raspagem para extração comercial de dados (mais contestada legalmente) é importante. A maioria dos crawlers legítimos de mecanismos de busca opera em território claramente legal.
Não — o ChatGPT em si não é um web crawler. O ChatGPT é um modelo de IA conversacional que gera respostas. No entanto, a OpenAI opera um web crawler separado chamado GPTBot, que rastreia páginas web públicas para coletar dados de treinamento para modelos de IA e para oferecer suporte a recursos de recuperação ao vivo em alguns produtos da OpenAI.
O GPTBot se identifica com o token de user-agent GPTBot e respeita as diretivas do robots.txt. Proprietários de sites que desejam bloquear o GPTBot especificamente podem adicionar o seguinte ao seu arquivo robots.txt:
User-agent: GPTBot
Disallow: /
Os crawlers de mecanismos de busca afetam diretamente todos no ecossistema de marketing de afiliados. Se uma página não é rastreada, ela não rankeia, e se não rankeia, não gera tráfego orgânico — e nenhuma receita de afiliados.
O site de conteúdo de um editor vive ou morre pela rastreabilidade. Cada review de produto, guia de comparação ou resumo de ofertas deve ser descoberto pelos crawlers. Erros comuns de editores que bloqueiam o rastreamento incluem:
Os editores devem verificar se suas páginas mais valiosas aparecem no relatório de cobertura do índice do Google Search Console e se nenhuma tag noindex ou regra de robots.txt as bloqueia acidentalmente.
Um anunciante que opera um programa de afiliados precisa que suas páginas de produto sejam rastreadas e indexadas para que os editores possam linkar para páginas ativas e visíveis. Se as páginas de produto de um comerciante não estiverem no índice do Google, os editores não têm para onde enviar tráfego. Riscos específicos incluem:
Os comerciantes devem manter estruturas de URL limpas, enviar sitemaps de produtos e monitorar as estatísticas de rastreamento no Search Console para detectar problemas antes que afetem os parceiros editores.
Os gerentes de programa ficam entre comerciantes e editores e devem entender o comportamento dos crawlers para solucionar problemas de visibilidade. Quando um editor relata que a página de produto de um comerciante “não aparece no Google”, o problema geralmente é de rastreamento ou indexação — não de classificação. Etapas práticas incluem:
site: do Google.Um gerente de programa que consegue diagnosticar problemas básicos de rastreamento agrega valor direto a ambos os lados do relacionamento de afiliados — ajudando comerciantes a corrigir problemas técnicos e ajudando editores a confirmar que as páginas que promovem são encontráveis.
Gerencie múltiplos programas de afiliados e melhore a performance dos seus parceiros afiliados com o Post Affiliate Pro.
Um spider de mecanismo de busca é um bot automatizado que rastreia páginas da web para indexar conteúdo em mecanismos como Google e Bing. Saiba como eles funcio...
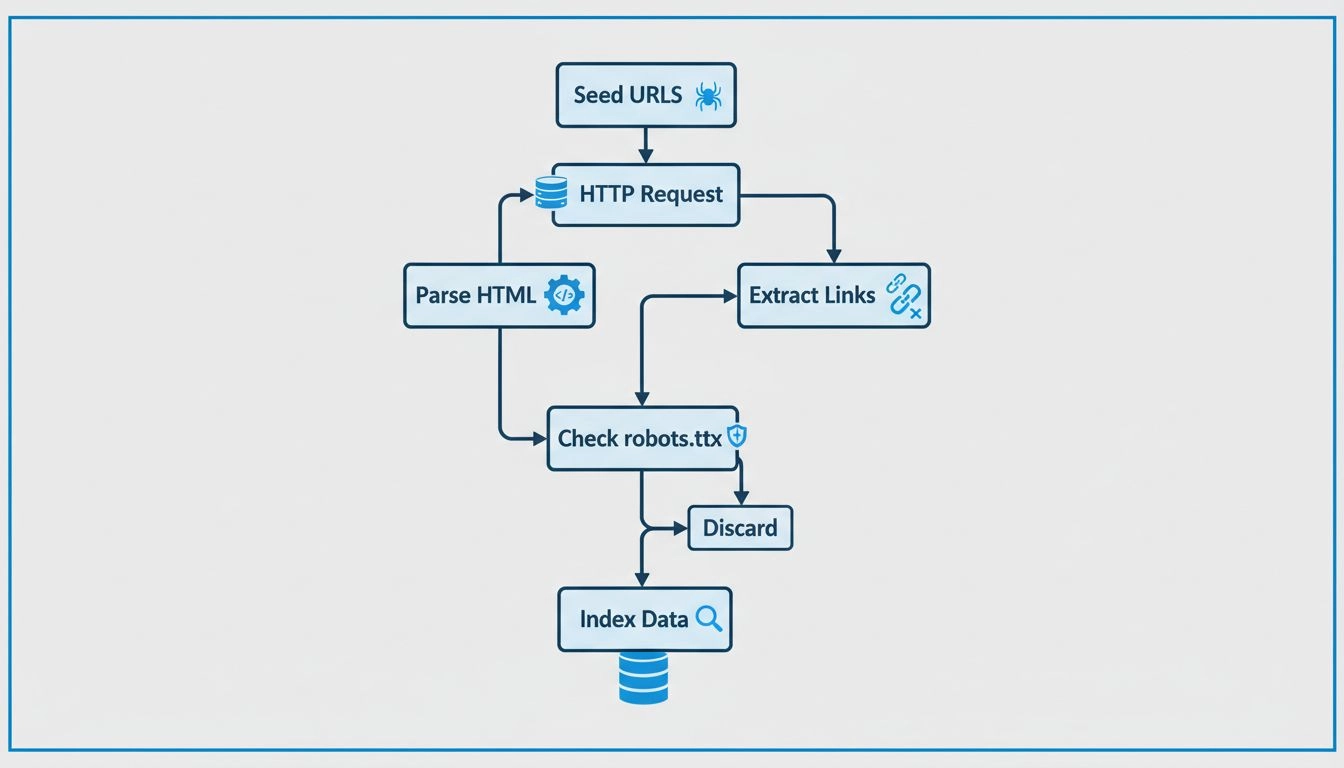
Descubra como funcionam os web crawlers, desde URLs iniciais até a indexação. Entenda o processo técnico, tipos de crawlers, regras do robots.txt e como eles im...
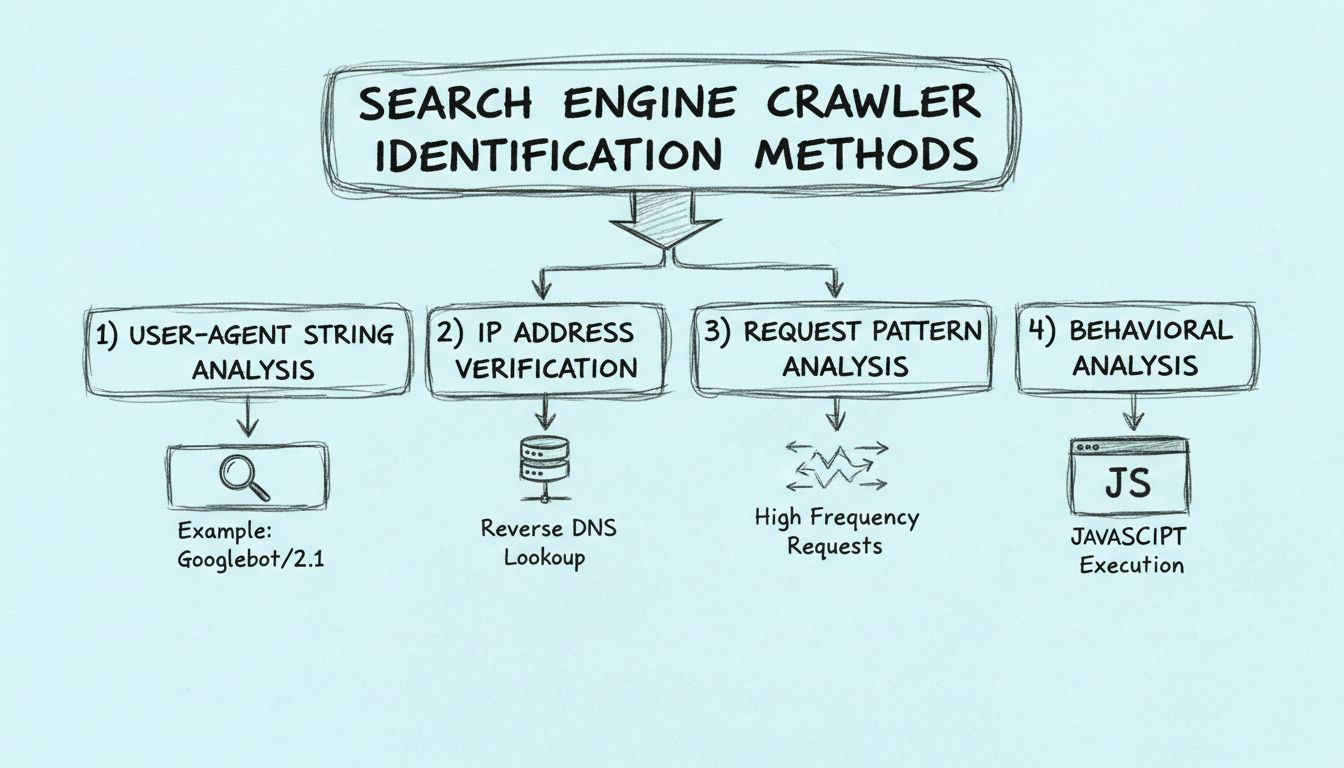
Aprenda como identificar crawlers de motores de busca utilizando strings de user-agent, endereços IP, padrões de requisição e análise comportamental. Guia essen...
Junte-se à nossa comunidade de clientes satisfeitos e forneça excelente suporte ao cliente com o Post Affiliate Pro.


See our privacy policy.