


Spider de mecanismo de busca
Um spider de mecanismo de busca é um bot automatizado que rastreia páginas da web para indexar conteúdo em mecanismos como Google e Bing. Saiba como eles funcio...
12 min de leitura
SEO
DigitalMarketing
+3
A detecção de spiders é o processo de identificar programas de software automatizados — chamados de spiders, rastreadores web ou bots — que visitam um site, e determinar se cada um serve a um propósito legítimo ou representa uma ameaça à integridade dos dados, aos gastos com anúncios ou à receita do programa de afiliados.
Detecção de spiders é o processo de identificar programas de software automatizados — chamados de spiders, rastreadores web ou bots — que visitam um site, e determinar se cada um serve a um propósito legítimo ou representa uma ameaça à integridade dos dados, aos gastos com anúncios ou à receita do programa de afiliados.
A detecção de spiders é uma disciplina de segurança e análise que identifica clientes HTTP automatizados examinando suas assinaturas técnicas, padrões comportamentais e características de rede. O termo “spider” (aranha) vem de como esses programas rastreiam a web — seguindo hiperlinks de página em página, da mesma forma que uma aranha percorre sua teia.
Na prática, a detecção de spiders responde a uma pergunta para cada visitante: isto é um humano, um bot amigável ou um script malicioso? A resposta determina se a visita é contabilizada em suas análises, se o clique gera uma comissão e se o lead entra no seu CRM.
Os três termos são frequentemente usados de forma intercambiável, mas carregam conotações diferentes dependendo do contexto:
Nem todo tráfego automatizado é hostil. Uma detecção de spiders eficaz distingue entre categorias:
| Categoria de Bot | Exemplos | Deve Bloquear? |
|---|---|---|
| Rastreadores de mecanismos de busca | Googlebot, Bingbot, YandexBot | Não — bloqueá-los remove você dos resultados de busca |
| Ferramentas de SEO e marketing | AhrefsBot, SemrushBot, Moz Dotbot | Caso a caso — consomem recursos mas podem ajudar na visibilidade |
| Monitoramento e validação | Rastreador do IAB Tech Lab, monitores de uptime | Não — eles verificam ads.txt, SSL e saúde do site |
| Raspadores de conteúdo | Bots não identificados copiando seu conteúdo | Sim — eles roubam conteúdo e não oferecem valor |
| Bots de fraude de clique | Scripts clicando em links de afiliados ou anúncios | Sim — eles roubam diretamente do seu orçamento |
| Bots de fraude de leads | Preenchedores automatizados de formulários enviando cadastros falsos | Sim — eles desperdiçam gastos de CPA e poluem seu CRM |
| Testadores de credenciais | Bots testando credenciais de login roubadas | Sim — são uma ameaça de segurança |
A linha entre “bom” e “mau” nem sempre é nítida. Um rastreador de SEO de uma ferramenta legítima ainda pode distorcer suas análises se você contar suas visitas como tráfego humano. A detecção de spiders fornece os dados para tomar decisões informadas, não apenas bloquear tudo indiscriminadamente.

Configure o rastreamento avançado em minutos. Não é necessário cartão de crédito.
A detecção moderna de spiders combina múltiplos sinais. Nenhuma verificação isolada é confiável por si só — bots sofisticados falsificam user-agents, alternam IPs e imitam o comportamento humano. Uma detecção eficaz combina vários métodos.
Toda requisição HTTP inclui um cabeçalho User-Agent que identifica o cliente que está fazendo a requisição. Rastreadores legítimos se declaram abertamente:
Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
Mozilla/5.0 (compatible; Bingbot/2.0; +http://www.bing.com/bingbot.htm)
Limitação: Qualquer bot pode fingir ser o Googlebot copiando sua string de user-agent. A análise de user-agent é um filtro de primeira passagem, não uma verificação conclusiva.
A maneira confiável de verificar a identidade declarada de um rastreador é cruzar seu endereço IP. Para os principais mecanismos de busca, o processo funciona assim:
*.googlebot.com para o Googlebot).Se todas as quatro etapas coincidirem, o rastreador é autêntico. Google, Bing e Yandex publicam suas faixas de IP e métodos de verificação. Qualquer bot que afirme ser o Googlebot, mas se conecte a partir de um endereço IP de um datacenter da AWS, é imediatamente sinalizado.
Humanos navegam de forma imprevisível. Eles fazem pausas entre visualizações de páginas, rolam em velocidades variáveis e clicam em padrões difíceis de replicar programaticamente. Bots deixam impressões digitais diferentes:
Sinais comportamentais são mais difíceis de falsificar do que cabeçalhos ou IPs. Eles exigem que o operador do bot simule interação humana, o que aumenta o custo e a complexidade do ataque o suficiente para dissuadir muitos fraudadores.
A impressão digital de dispositivos coleta atributos do cliente que se conecta — versão do navegador, fontes instaladas, resolução de tela, renderizador WebGL e dezenas de outros sinais — para criar um identificador único. Quando a mesma impressão digital aparece em centenas de “visitantes diferentes”, ou quando uma impressão digital não corresponde ao user-agent declarado, os sistemas de detecção de spiders sinalizam o tráfego.
| Método | O que Verifica | Pontos Fortes | Pontos Fracos |
|---|---|---|---|
| Análise de user-agent | String de identificação do navegador/cliente | Filtro inicial rápido e sem custo | Facilmente falsificável |
| Verificação de IP/DNS reverso | Origem de rede e correspondência de hostname | Conclusivo para rastreadores conhecidos | Funciona apenas para bots declarados |
| Análise comportamental | Tempo das requisições, padrões de navegação | Difícil de falsificar em escala | Requer dados de sessão |
| Impressão digital de dispositivos | Atributos do navegador e hardware | Sinal forte de fraude | Regulamentações de privacidade podem se aplicar |
| Desafios de JavaScript | Capacidade de executar scripts | Bloqueia scripts simples | Rastreadores legítimos podem não executar JS |
| Armadilhas honeypot | Links ocultos que apenas bots seguem | Detecção de bots de alta confiança | Requer instrumentação do site |
Programas de afiliados pagam parceiros por desempenho — cliques, leads ou vendas. Cada evento fraudulento contabilizado como legítimo custa dinheiro real. A detecção de spiders é a primeira linha de defesa contra várias categorias de fraude de afiliados.
A fraude de clique é o ataque mais direto aos orçamentos de afiliados. Um bot simula cliques em links de afiliados, inflando as métricas de clique sem qualquer engajamento humano. O afiliado recebe pagamento por tráfego que nunca teve chance de conversão.
A detecção de spiders captura a fraude de clique identificando os padrões automatizados por trás dos cliques: IPs de datacenters, cliques repetidos de impressões digitais idênticas de dispositivos e velocidades de clique que nenhum humano poderia produzir.
Em programas de afiliados de custo por lead (CPL), bots enviam formulários de cadastro falsos para gerar pagamentos de comissão. Esses leads parecem reais à primeira vista — têm nomes, endereços de e-mail e números de telefone — mas nunca convertem além disso.
A detecção de spiders sinaliza leads falsos verificando se o envio veio de um IP de datacenter, de um dispositivo falsificado ou de um domínio de e-mail descartável — sinais que um usuário humano raramente produziria.
Cookie stuffing é uma forma mais sorrateira de fraude. Um script insere cookies de rastreamento de afiliados no navegador do usuário sem seu conhecimento — geralmente através de um pop-under, uma imagem de 1×1 pixel ou um script injetado em uma página comprometida. Quando esse usuário faz uma compra posteriormente, o fraudador reivindica a comissão.
A detecção de spiders identifica os scripts automatizados que realizam cookie stuffing por sua assinatura comportamental: requisições rápidas e invisíveis que definem cookies sem qualquer visita de página ou interação do usuário correspondente.
Além da perda financeira direta, o tráfego de bots corrompe todas as métricas nas quais você confia. As taxas de conversão caem porque o tráfego de bots infla seu denominador. O desempenho das campanhas se torna ilegível. Equipes de marketing otimizam para coortes que nunca existiram.
Uma detecção limpa de spiders restaura a confiança em seus dados. Quando você filtra o tráfego de bots antes que ele chegue às suas análises, você vê o que seus usuários humanos realmente fazem — e pode tomar decisões baseadas na realidade.
Seja o primeiro a saber sobre novos recursos e atualizações do produto.
O IAB (Interactive Advertising Bureau) Tech Lab mantém a referência padrão da indústria para detecção de spiders: a Lista Internacional de Spiders e Bots do IAB/ABC. Ela é a base sobre a qual a maioria dos sistemas sérios de prevenção de fraudes é construída.
A lista consiste em dois arquivos de texto atualizados regularmente:
O IAB prescreve uma abordagem de duas etapas definida em suas Diretrizes de Medição de Impressões de Anúncios:
Este método de dupla passagem é o padrão para detecção de tráfego inválido (IVT) credenciada pelo MRC. Ele garante que rastreadores declarados sejam filtrados enquanto bots desconhecidos não escapem simplesmente por não estarem em nenhuma lista.
O acesso requer um acordo de assinatura de dados assinado e é provisionado através do Portal de Ferramentas do Tech Lab. Um login de conta por empresa assinante. Para a maioria dos gerentes de programas de afiliados, a lista é acessada indiretamente — através da plataforma de detecção de fraudes ou ferramenta de análise que já utilizam, que licencia a lista em seu nome.
Esses sistemas integrados filtram automaticamente o tráfego de bots dos seus relatórios, de modo que cliques e conversões atribuídos a rastreadores conhecidos nunca entrem em seus cálculos de comissão.
A vantagem da detecção em nível de plataforma é que ela não requer configuração — funciona pronta para uso, mantida pelo fornecedor, com a lista do IAB integrada.
Para programas com maior exposição a fraudes — grandes pagamentos de CPA, altos volumes de tráfego ou indústrias visadas por esquemas fraudulentos — plataformas dedicadas de prevenção de fraudes adicionam camadas além da detecção básica de spiders:
Mesmo sem uma plataforma dedicada, os gerentes de programa podem monitorar vários sinais manualmente:
Uma armadilha de spider é um conjunto de páginas geradas dinamicamente que criam um loop infinito para rastreadores web. Exemplos comuns incluem:
Um rastreador legítimo que encontra uma armadilha de spider pode queimar todo o seu orçamento de rastreamento — o número de páginas que ele aloca para seu site — indexando milhares de páginas quase duplicadas enquanto perde seu conteúdo real.
Armadilhas de spiders prejudicam seu site de duas maneiras. Primeiro, desperdiçam o orçamento de rastreamento: o Googlebot gasta sua alocação em URLs sem sentido em vez de suas páginas de produto e postagens de blog. Segundo, podem degradar o desempenho do servidor à medida que os rastreadores sobrecarregam páginas geradas dinamicamente.
A correção é simples: use robots.txt para desautorizar o rastreamento de padrões de URL propensos a armadilhas, adicione tags rel="canonical" para consolidar páginas duplicadas e evite expor espaços infinitos de URL através de links internos. Sistemas de detecção de spiders também podem identificar quando um rastreador conhecido está preso em uma armadilha e limitar seu acesso de acordo.
Proteja suas campanhas de afiliados e a integridade dos dados com ferramentas avançadas de detecção de spiders e estratégias de prevenção de fraudes.
Um spider de mecanismo de busca é um bot automatizado que rastreia páginas da web para indexar conteúdo em mecanismos como Google e Bing. Saiba como eles funcio...
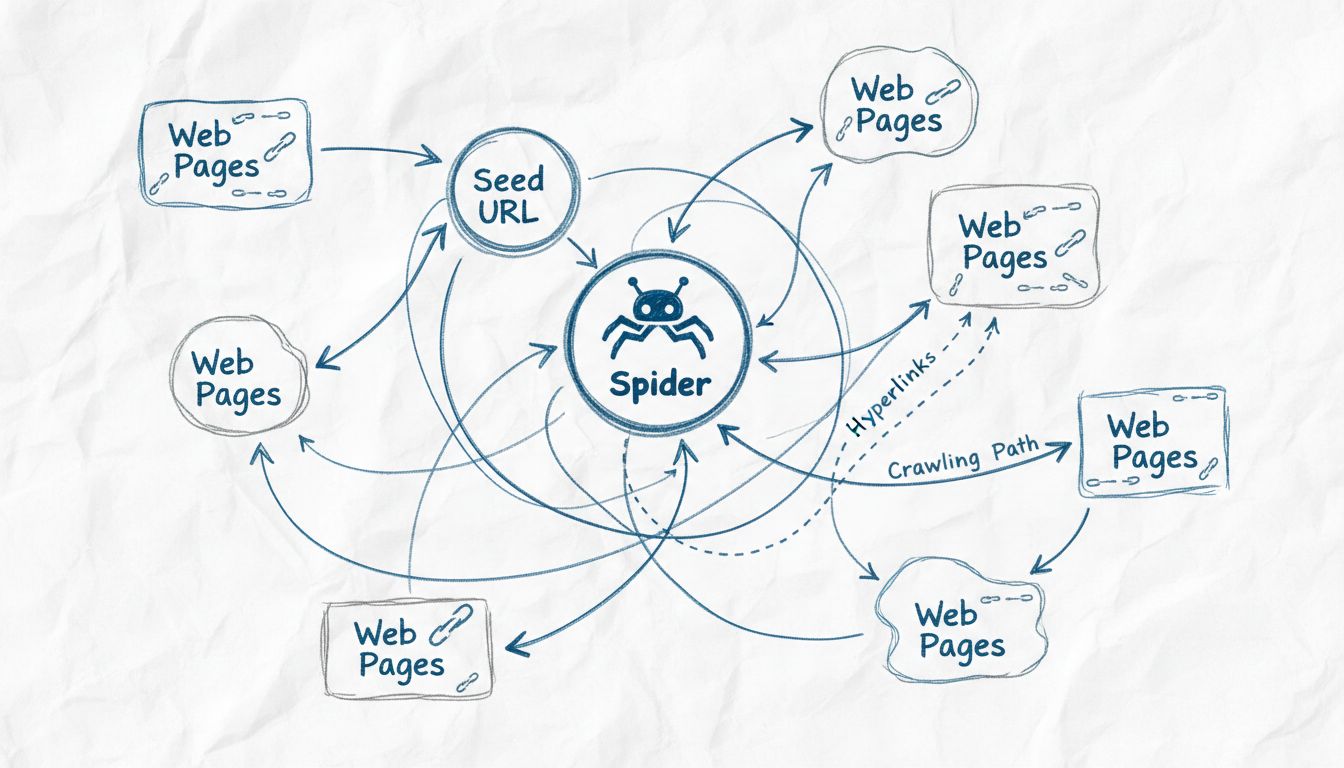
Descubra por que os rastreadores da web são chamados de spiders, como funcionam e seu papel fundamental na indexação dos mecanismos de busca. Conheça os mecanis...
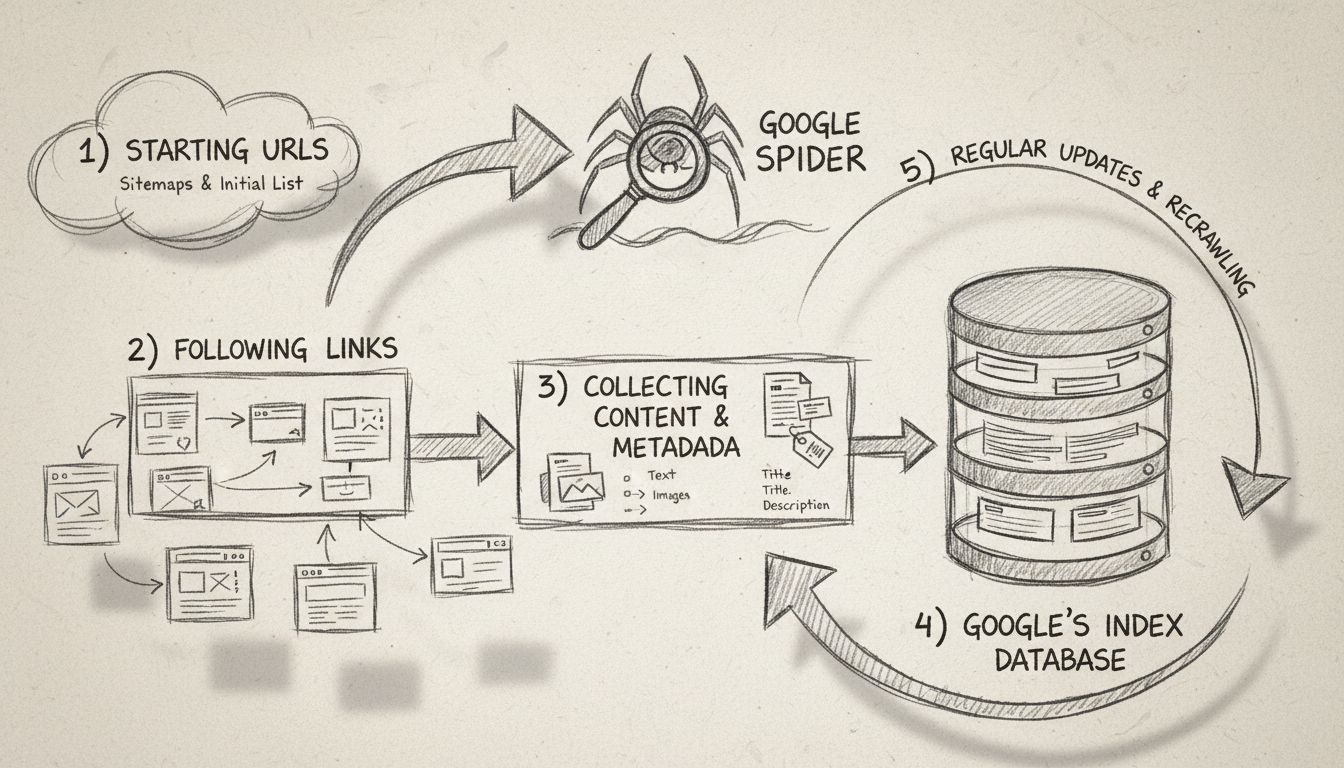
Descubra o que é o Google Spider (Googlebot), como ele rastreia e indexa sites e por que é essencial para o SEO. Aprenda como otimizar seu site para um melhor r...
Junte-se à nossa comunidade de clientes satisfeitos e forneça excelente suporte ao cliente com o Post Affiliate Pro.


See our privacy policy.