

O Google Usa Palavras-chave LSI? A Verdade Sobre SEO Semântico
Descubra se o Google utiliza palavras-chave LSI e entenda como a busca semântica moderna realmente funciona. Compreenda BERT, RankBrain e otimização baseada em ...
12 min de leitura
A indexação semântica latente (LSI) é uma técnica matemática do processamento de linguagem natural e recuperação de informação que revela relações ocultas — ou latentes — entre palavras e documentos.
Nesta página
A indexação semântica latente (LSI) é uma técnica matemática do processamento de linguagem natural e recuperação de informação que revela relações ocultas — ou latentes — entre palavras e documentos. Em vez de corresponder palavras-chave exatas, o LSI analisa padrões de co-ocorrência de palavras em uma coleção de documentos para inferir sobre o que cada documento realmente se trata.
Detalhando o nome, o conceito fica mais claro:

Configure o rastreamento avançado em minutos. Não é necessário cartão de crédito.
O LSI funciona por meio de uma sequência de etapas matemáticas bem definidas. Compreendê-las — mesmo que em alto nível — esclarece por que a técnica é importante e onde estão seus limites.
O LSI começa construindo uma matriz termo-documento. Cada linha representa um termo único do corpus, cada coluna representa um documento, e cada célula registra quantas vezes aquele termo aparece naquele documento — ou, mais comumente, um valor ponderado como TF-IDF (frequência do termo–frequência inversa do documento).
| Doc 1 | Doc 2 | Doc 3 | |
|---|---|---|---|
| carro | 3 | 0 | 1 |
| automóvel | 0 | 4 | 1 |
| motor | 2 | 3 | 0 |
| restaurante | 0 | 0 | 5 |
Essa matriz é tipicamente grande e esparsa — a maioria das células é zero, pois qualquer documento usa apenas uma pequena fração do vocabulário total.
A operação matemática central no LSI é a decomposição por valores singulares. A SVD divide a matriz termo-documento em três matrizes menores:
A ≈ Uₖ Σₖ Vₖᵀ
Ao manter apenas os k maiores valores singulares (e descartar o restante), o LSI reduz a matriz a uma representação muito menor e mais densa. Essa etapa remove ruídos, mescla termos relacionados e revela a estrutura semântica latente. A escolha de k é crítica: muito pequeno e você perde distinções significativas; muito grande e você retém ruídos. Na prática, k geralmente varia de 100 a 300 para coleções de tamanho moderado.
Uma vez que documentos e termos são mapeados no espaço semântico reduzido, compará-los se torna simples. Uma consulta é projetada no mesmo espaço, e seu vetor é comparado a cada vetor de documento usando similaridade por cosseno — uma medida que captura o ângulo entre dois vetores, com valores próximos de 1 indicando maior similaridade.
Os termos indexação semântica latente (LSI) e análise semântica latente (LSA) são frequentemente usados de forma intercambiável, e por um bom motivo: descrevem o mesmo procedimento matemático subjacente. A diferença é de aplicação, não de técnica.
Em resumo: LSA é a técnica de análise; LSI é sua aplicação à busca e recuperação. O artigo original de Deerwester et al. (1990) usou o termo “latent semantic indexing”, razão pela qual a comunidade de recuperação de informação adotou LSI, enquanto as comunidades mais amplas de PLN e ciência cognitiva tendem a preferir LSA.
Seja o primeiro a saber sobre novos recursos e atualizações do produto.
O LSI foi implantado em diversos sistemas do mundo real, especialmente antes do avanço das abordagens baseadas em redes neurais.
O LSI foi uma das primeiras técnicas a viabilizar a busca semântica — recuperar documentos com base na relevância conceitual, em vez de sobreposição de palavras-chave. Sistemas empresariais de busca antigos, catálogos de bibliotecas digitais e bases de dados de pesquisa acadêmica usavam LSI para melhorar a revocação: a proporção de documentos relevantes efetivamente recuperados.
Como o LSI mapeia documentos em um espaço semântico compartilhado, ele naturalmente suporta agrupamento. Documentos sobre tópicos similares acabam próximos uns dos outros no espaço reduzido, mesmo que não compartilhem vocabulário exato. Isso tornou o LSI útil para categorização automática de tópicos, revisão de documentos jurídicos e busca de patentes.
Uma das aplicações mais citadas da LSA fora da busca é o Intelligent Essay Assessor, desenvolvido no final dos anos 1990. O sistema usava LSA para comparar redações de alunos com um corpus de textos escritos por especialistas, produzindo notas que se correlacionavam bem com as de avaliadores humanos. Essa aplicação demonstrou que a LSA podia capturar algo significativo sobre o conteúdo textual sem qualquer regra linguística ou conhecimento específico de domínio.
A pesquisa original da LSA foi motivada em parte por questões da psicologia cognitiva. Landauer e Dumais mostraram que a LSA conseguia replicar aspectos da aquisição de vocabulário humano e efeitos de priming semântico, sugerindo que apenas a estrutura estatística da exposição à linguagem poderia explicar porções significativas de como as pessoas aprendem significados de palavras.
Não. O Google não utiliza indexação semântica latente em seus algoritmos de ranqueamento. Isso não é especulação — representantes do Google já declararam isso diretamente.
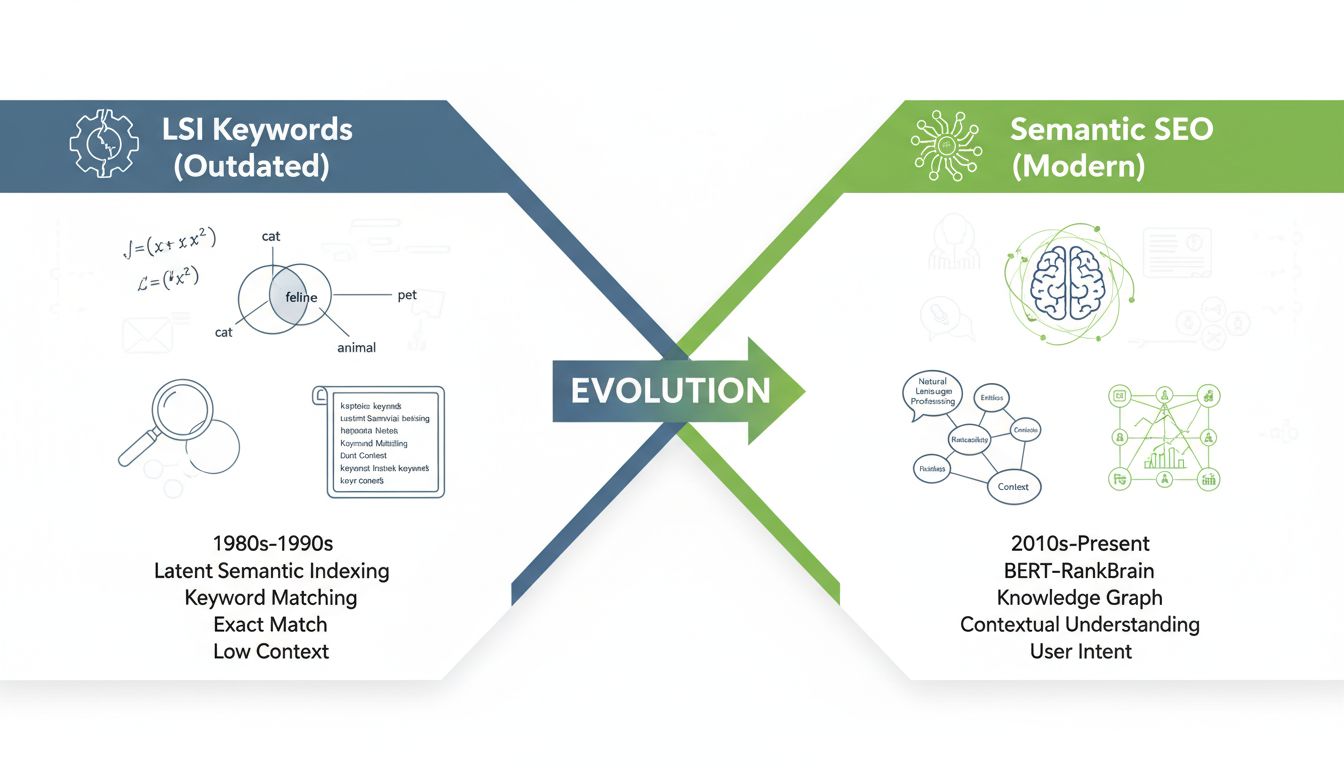
A confusão tem uma raiz histórica. No início dos anos 2000, à medida que o algoritmo do Google se tornava mais sofisticado na compreensão de contexto, profissionais de SEO buscaram um框架 para explicar o que estavam observando. O LSI — uma técnica real e publicada para compreensão semântica — forneceu um rótulo conveniente. A ideia de que o Google pudesse usar algo como LSI para “enxergar através” do excesso de palavras-chave e entender tópicos de páginas era plausível o suficiente para pegar.
Mas a abordagem moderna do Google para compreender conteúdo é muito mais avançada. Sistemas como RankBrain (introduzido em 2015), neural matching e BERT (2019) usam aprendizado profundo e arquiteturas baseadas em transformers para modelar a linguagem. Esses sistemas processam ordem das palavras, janelas de contexto, relações entre entidades e sinais de interação do usuário — nada disso é tratado pelo LSI. O LSI é uma técnica de álgebra linear que opera em uma representação estática de saco de palavras; a infraestrutura do Google é ordens de magnitude mais complexa.
Em meados dos anos 2000, ferramentas e blogs de SEO começaram a promover a ideia de que o Google usava LSI para identificar termos relacionados e penalizar páginas que careciam de profundidade semântica. O conceito era atraente: dava aos profissionais de SEO uma justificativa de som científico para escrever conteúdo mais rico e uma tática do tipo lista de verificação (encontre suas palavras-chave LSI, espalhe-as pelo texto, ranqueie melhor). Surgiram ferramentas que afirmavam gerar palavras-chave LSI para qualquer tópico.
O problema é que essa narrativa confunde duas coisas distintas: a técnica matemática chamada LSI e a prática geral de usar termos relacionados no conteúdo.
A recomendação subjacente — escrever conteúdo abrangente e ricamente temático — continua válida. O rótulo é que é enganoso.
No sentido técnico estrito: não. Não existe nenhum algoritmo no Google que pegue uma consulta, execute SVD em uma matriz termo-documento e devolva uma lista de “palavras-chave LSI” que você deve incluir em sua página.
O que realmente existe é o fenômeno observável de que páginas bem ranqueadas para uma determinada consulta tendem a usar um vocabulário mais amplo de termos relacionados. Isso é uma correlação, não evidência de um mecanismo baseado em LSI. Os mecanismos de busca modernos usam modelos neurais de linguagem treinados em corpora vastos para entender que “eficiência de combustível”, “km/l” e “motor híbrido” são todos relevantes para uma página sobre carros — sem nunca construir uma matriz termo-documento ou calcular um único valor singular.
Se você está construindo um sistema de busca, um mecanismo de recomendação de conteúdo ou qualquer aplicação que precise entender similaridade semântica entre textos, a resposta é clara: use embeddings.
O LSI tem algumas vantagens de nicho. É transparente — você pode inspecionar os vetores de termos e documentos e entender quais dimensões contribuem para a similaridade. Não requer dados de treinamento além da própria coleção de documentos. Funciona em hardware modesto e pode ser implementado em algumas dezenas de linhas de Python usando o TruncatedSVD do scikit-learn. Para uma coleção pequena e estática de documentos — digamos, alguns milhares de descrições de produtos em um site de afiliados — o LSI pode entregar resultados aceitáveis com complexidade mínima.
Modelos modernos de embedding — sejam transformers de frase como all-MiniLM-L6-v2, APIs proprietárias da OpenAI ou Cohere, ou modelos de pesos abertos — capturam relações semânticas muito mais ricas do que o LSI jamais conseguiria. Eles entendem ordem das palavras, negação, relações entre entidades e semântica multilíngue. Lidam com polissemia de forma contextual: “banco” como instituição financeira e “banco” como assento recebem representações vetoriais diferentes dependendo das palavras ao redor.
| Critério | LSI | Embeddings Modernos |
|---|---|---|
| Lida com sinônimos | Sim, parcialmente | Sim, eficazmente |
| Lida com polissemia | Não (um vetor por termo) | Sim (contextual) |
| Captura ordem das palavras | Não (saco de palavras) | Sim |
| Dados de treinamento necessários | Nenhum além do corpus alvo | Pré-treinado em grandes corpora |
| Custo computacional | Baixo | Moderado a alto |
| Interpretabilidade | Alta (dimensões inspecionáveis) | Baixa (vetores de caixa-preta) |
| Melhor para | Coleções pequenas e estáticas | Busca em produção, RAG, recomendações |
Para qualquer projeto que vá crescer, atender usuários reais ou precisar entender consultas com nuances, os embeddings são a escolha certa.
Apesar de ter sido superado para buscas em grande escala, o LSI continua relevante em vários contextos específicos.
O LSI é uma excelente ferramenta de ensino. Sua mecânica — construir uma matriz, decompô-la e medir similaridade no espaço reduzido — torna concreta a ideia abstrata de “similaridade semântica”. Alunos que implementam LSI do zero adquirem uma compreensão genuína de modelos de espaço vetorial que se transfere diretamente para o trabalho com embeddings modernos.
Para uma coleção de alguns milhares de documentos — wikis internas, catálogos de produtos, contratos jurídicos — o LSI pode ser implantado rapidamente, sem GPU, sem custos de API e sem infraestrutura de servidor de modelo. Os resultados não são estado da arte, mas geralmente são bons o suficiente para ferramentas internas e protótipos.
Pesquisadores e engenheiros ainda usam o LSI como linha de base ao avaliar novas técnicas de recuperação ou modelagem de tópicos. Se seu novo modelo neural sofisticado mal supera um método de álgebra linear de 30 anos, você tem um problema. O LSI estabelece um piso útil.
Alguns sistemas empresariais de busca e gerenciamento de documentos implantaram o LSI há anos e não têm motivo convincente para migrar. Se a coleção é estável, os padrões de consulta são bem compreendidos e os usuários estão satisfeitos, substituir o LSI por embeddings pode ser uma solução em busca de um problema.
Se o LSI não é um fator de ranqueamento do Google e as “palavras-chave LSI” não existem, o que um profissional de marketing de afiliados ou gerente de programa deve realmente fazer? A resposta é mais simples — e mais eficaz — do que caçar uma lista mágica de palavras-chave.
A verdadeira percepção por trás do conceito de palavras-chave LSI é que páginas que cobrem um tópico de forma completa tendem a ranquear melhor. Isso não requer SVD. Requer entender quais perguntas seu público tem e respondê-las. Para uma página de afiliado que avalia rastreadores fitness, isso significa cobrir duração da bateria, classificação à prova d’água, precisão da medição cardíaca, qualidade do aplicativo complementar e comparações de preço — não porque um algoritmo exija esses termos, mas porque os leitores os exigem.
Ferramentas de pesquisa de palavras-chave são valiosas para descobrir consultas relacionadas, entender volume de busca e analisar conteúdo de concorrentes. Use-as para isso. Não as use porque elas afirmam gerar “palavras-chave LSI”. O preenchimento automático do Google, as caixas “As pessoas também perguntam” e as “Pesquisas relacionadas” no final da SERP são gratuitos e refletem diretamente consultas reais de usuários — são mais úteis do que qualquer ferramenta LSI de terceiros.
A abordagem moderna do Google para compreensão de conteúdo gira em torno de entidades — coisas reais do mundo, pessoas, lugares e conceitos — e suas relações. Quando você escreve sobre um produto, mencione a marca, a categoria, o caso de uso, as alternativas e as especificações relevantes. Estas são entidades. Abordá-las naturalmente sinaliza profundidade temática de uma forma que um sistema de aprendizado de máquina pode reconhecer, sem necessidade de uma técnica obsoleta de decomposição de matrizes.
O LSI tem limitações bem documentadas que explicam por que foi amplamente superado.
O LSI trata cada documento como uma coleção não ordenada de palavras. Ordem das palavras, sintaxe e estrutura gramatical são totalmente ignoradas. “O cachorro mordeu o homem” e “o homem mordeu o cachorro” produzem representações idênticas. Para muitas consultas do mundo real, isso importa.
No LSI, cada termo recebe exatamente um vetor — independentemente do contexto. A palavra “manga” (fruta vs. parte da roupa) tem a mesma representação em todos os documentos. Embeddings contextuais modernos resolvem isso produzindo vetores diferentes para a mesma palavra em contextos diferentes.
O LSI constrói seu espaço semântico a partir de uma coleção fixa de documentos. Adicionar novos documentos requer recalcular a SVD — ou, no mínimo, projetar novos documentos no espaço existente, o que pode não capturar bem o novo vocabulário. Isso torna o LSI inadequado para coleções dinâmicas como feeds de notícias ou catálogos de produtos constantemente atualizados.
A SVD é computacionalmente cara em matrizes grandes. Uma matriz termo-documento para uma coleção em escala web seria intratável. A técnica foi projetada para coleções de milhares a dezenas de milhares de documentos — ordens de magnitude menores do que os mecanismos de busca modernos manipulam.
O LSI não consegue distinguir “bom” de “não bom” — ambos contêm “bom” em proximidade semelhante a outros termos. Sentimento, sarcasmo e distinções sutis de significado estão além de seu alcance.
A expressão “palavras-chave LSI” é frequentemente usada de forma leviana em conselhos de SEO. Uma palavra relacionada não é evidência de que um mecanismo de busca utiliza indexação semântica latente. Para um comparativo de afiliados ou guia de produtos, cubra as perguntas reais do comprador e explique conceitos relevantes de forma natural; não adicione uma lista de supostos termos LSI para tentar melhorar rankings.
Descubra como aproveitar o LSI e palavras-chave semânticas para melhorar a relevância de busca do seu conteúdo e gerar mais tráfego orgânico. Conheça as soluções do Post Affiliate Pro para profissionais de marketing de afiliados.
Descubra se o Google utiliza palavras-chave LSI e entenda como a busca semântica moderna realmente funciona. Compreenda BERT, RankBrain e otimização baseada em ...
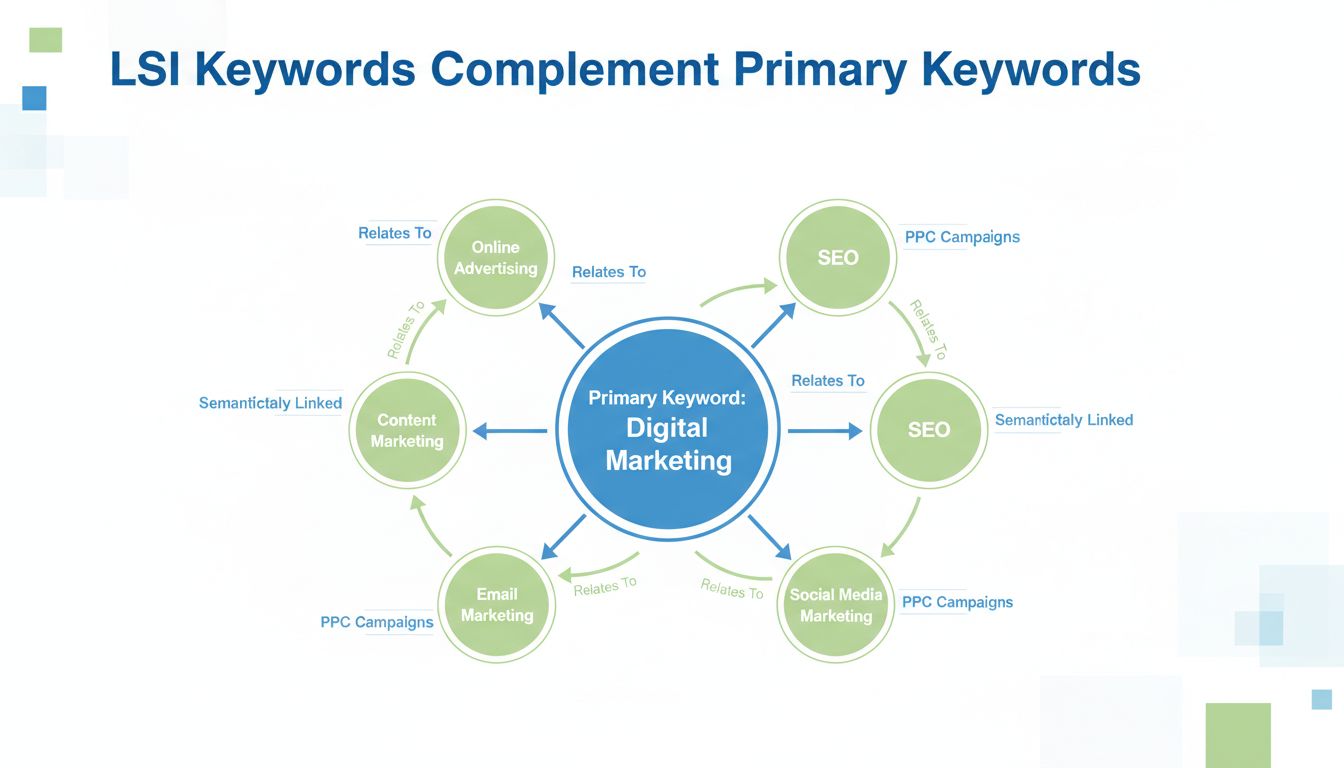
Saiba por que as palavras-chave LSI devem complementar, e não substituir, suas palavras-chave primárias. Descubra como palavras-chave semânticas aumentam a rele...

Saiba a frequência ideal para atualizar conteúdos com palavras-chave LSI. Descubra as melhores práticas para pesquisa de palavras-chave, otimização on-page e cr...
Junte-se à nossa comunidade de clientes satisfeitos e forneça excelente suporte ao cliente com o Post Affiliate Pro.
See our privacy policy.