O que é Significância Estatística?
A Definição Central
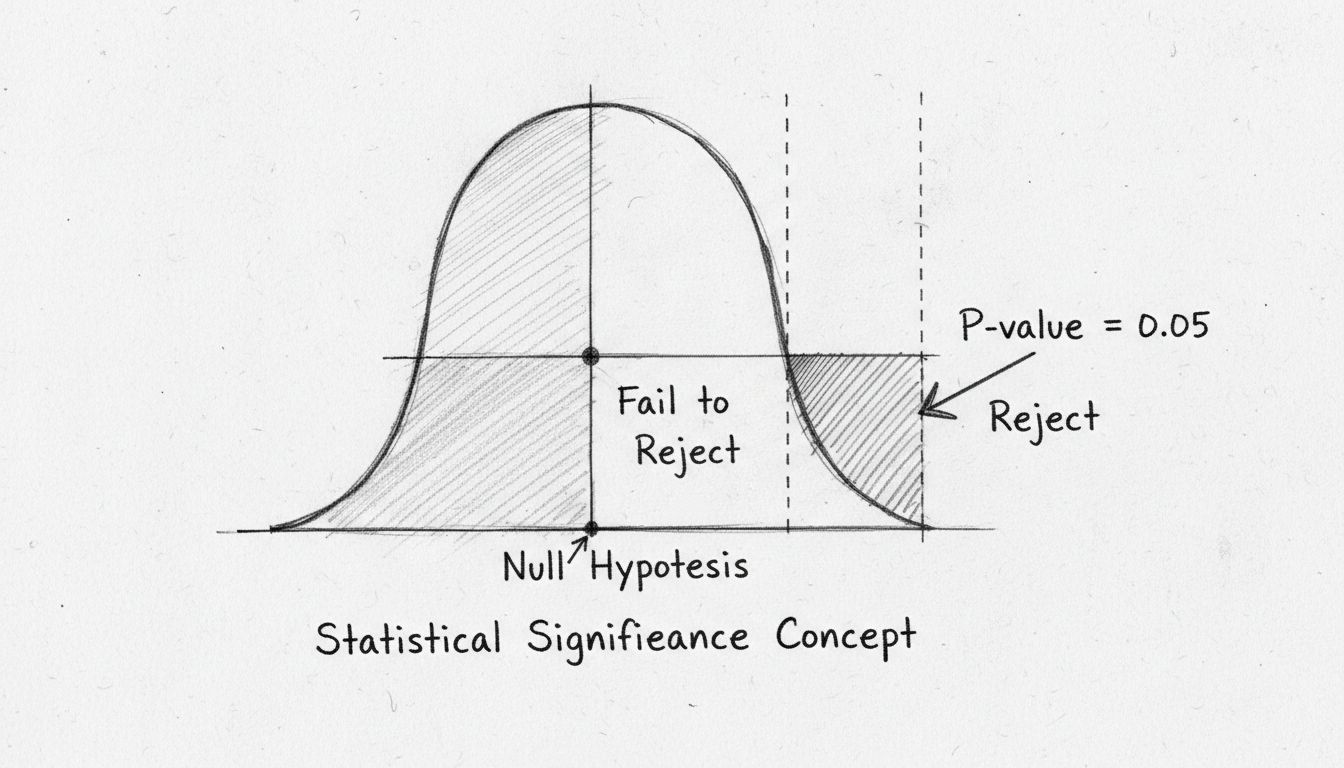
Significância estatística é a probabilidade de que uma relação entre duas ou mais variáveis seja causada por algo além do acaso. Em termos formais, é a probabilidade de que uma diferença observada — ou uma mais extrema — ocorreria se a hipótese nula (a suposição de que não há efeito real) fosse verdadeira.
Significância Estatística vs. Acaso Aleatório
Todo conjunto de dados contém variação aleatória — a flutuação natural que ocorre mesmo quando não existe nenhum efeito subjacente. Jogue uma moeda honesta 100 vezes, e raramente você obterá exatamente 50 caras. Esse desvio é ruído aleatório, não evidência de que a moeda é tendenciosa.
A significância estatística quantifica se o desvio que você vê é grande o suficiente, em relação ao tamanho da sua amostra, para ser improvável apenas sob o ruído aleatório. Quando é, você pode rejeitar a hipótese nula e concluir que um efeito real provavelmente existe.
Dois conceitos relacionados ajudam aqui:
- Acaso aleatório: A probabilidade de que uma diferença observada surja puramente da variabilidade da amostragem.
- Variação aleatória (ou ruído aleatório): A imprevisibilidade inerente a qualquer processo de medição. Amostras maiores reduzem sua influência, tornando os efeitos reais mais fáceis de detectar.
Um Exemplo Simples do Mundo Real
Suponha que você administre uma loja online e teste duas versões de uma página de produto. A Versão A converte em 4,2%. A Versão B converte em 4,8%. Essa é uma diferença de 0,6 ponto percentual — mas será que é real?
Você executa um teste estatístico. Ele retorna um valor-p de 0,03.
Se o valor-p fosse 0,30, no entanto, a mesma diferença seria totalmente consistente com o acaso — e agir com base nela seria prematuro.
Lance seu programa de afiliados hoje
Configure o rastreamento avançado em minutos. Não é necessário cartão de crédito.
Como a Significância Estatística Funciona
A Hipótese Nula e a Hipótese Alternativa
Todo teste de significância começa com duas afirmações concorrentes:
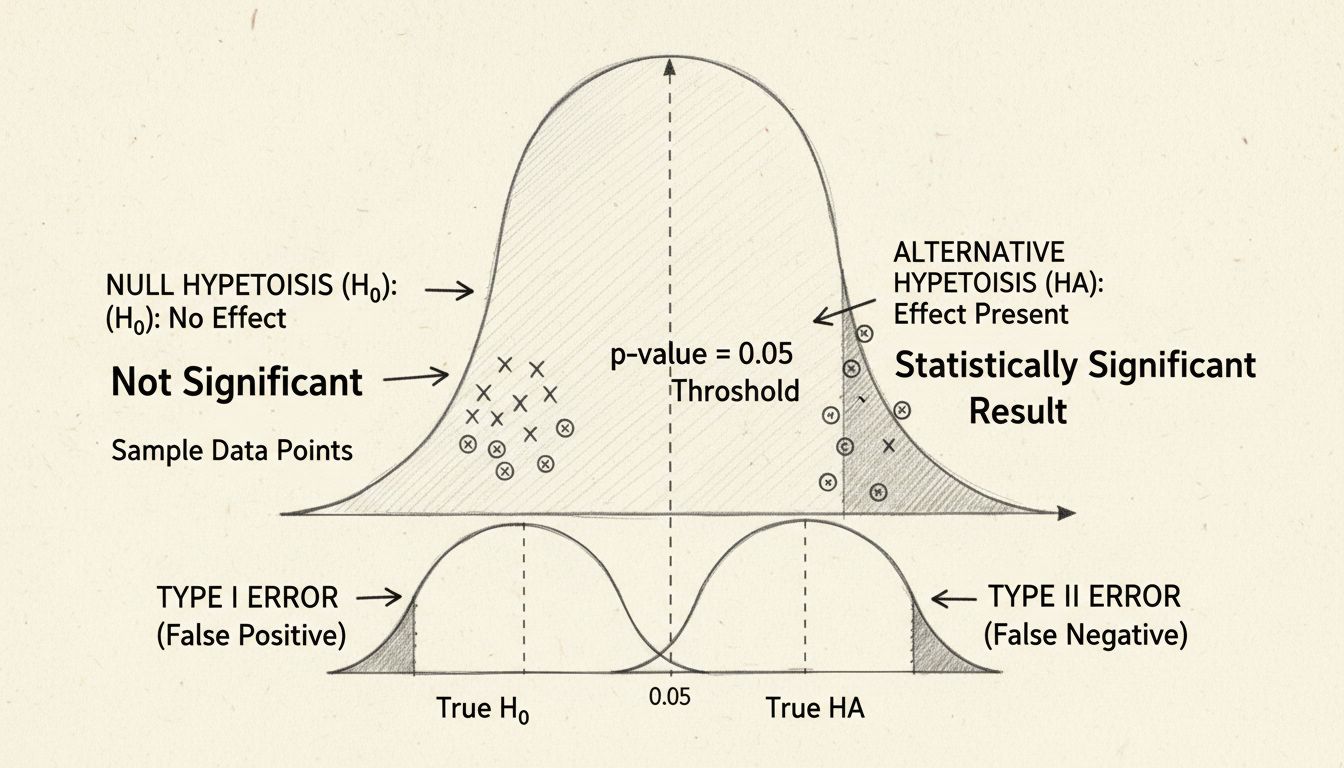
- Hipótese nula (H₀): Não há diferença ou relação real. Qualquer diferença observada é devida à variação aleatória.
- Hipótese alternativa (H₁): Há uma diferença ou relação real.
Entendendo os Valores-P
Interpretações equivocadas comuns a evitar:
- p = 0,03 NÃO significa que há 3% de chance de a hipótese nula ser verdadeira. Descreve a probabilidade dos dados sob a hipótese nula, não a probabilidade da hipótese nula dados os dados.
- p = 0,03 NÃO significa que o efeito tem 97% de chance de ser real. O valor-p não diz nada sobre a probabilidade de a hipótese alternativa estar correta.
- Um valor-p acima de 0,05 NÃO prova a hipótese nula. Significa que os dados não são surpreendentes o suficiente para rejeitá-la — o que é uma afirmação completamente diferente.
Níveis de Significância (Alpha)
O nível de significância, denotado α (alpha), é o limite que você define antes de executar um teste. Ele representa sua tolerância para falsos positivos — rejeitar a hipótese nula quando ela é realmente verdadeira. Isso também é chamado de erro Tipo I.
| Limiar | Significado | Risco de Falso Positivo |
|---|
| α = 0,05 | Padrão na maioria dos campos | 5% (1 em 20) |
| α = 0,01 | Mais rigoroso; usado quando falsos positivos são custosos | 1% (1 em 100) |
| α = 0,001 | Muito rigoroso; decisões de alto risco | 0,1% (1 em 1.000) |
Se p < α, o resultado é estatisticamente significativo nesse nível.
Intervalos de Confiança Explicados
Um intervalo de confiança fornece uma faixa de valores plausíveis para o tamanho real do efeito. Um intervalo de confiança de 95% significa: se você repetisse o estudo 100 vezes, cerca de 95 desses intervalos conteriam o valor real.
Intervalos mais estreitos indicam estimativas mais precisas — tipicamente resultado de amostras maiores. Em contextos de negócios, os intervalos de confiança são frequentemente mais informativos do que os valores-p isoladamente, pois mostram a magnitude e a direção de um efeito, não apenas se ele existe.
0,05 é Estatisticamente Significativo? (e Outros Limites)
A Convenção de 0,05
Sim — na maioria dos campos aplicados, p < 0,05 é o padrão para afirmar significância estatística. Essa convenção remonta ao trabalho de Ronald Fisher na década de 1920 e, embora um tanto arbitrária, persistiu porque equilibra dois riscos: falsos positivos (erros Tipo I) e falsos negativos (erros Tipo II, onde um efeito real é perdido).
0,01 vs. 0,05: Qual é Mais Significativo?
Um valor-p de 0,01 é mais significativo estatisticamente do que 0,05 porque indica uma probabilidade menor de que o resultado observado seja devido ao acaso. Em α = 0,01, você está aceitando apenas um risco de 1% de falso positivo, em comparação com 5% em α = 0,05.
No entanto, um valor-p menor não significa automaticamente um efeito maior ou mais importante. Com uma amostra enorme, mesmo uma diferença trivialmente pequena pode produzir p < 0,001. É por isso que o tamanho do efeito e a significância prática devem ser avaliados juntamente com o valor-p.
Assine nossa newsletter
Seja o primeiro a saber sobre novos recursos e atualizações do produto.
Fatores que Afetam a Significância Estatística
Tamanho da Amostra
O tamanho da amostra é o fator mais influente. Amostras maiores reduzem o impacto da variação aleatória, tornando mais fácil detectar diferenças reais. É por isso que um aumento de 2% na conversão pode ser significativo com 50.000 visitantes, mas não com 500.
Tamanho do Efeito
O tamanho do efeito mede a magnitude da diferença observada — não apenas se ela existe. Um tamanho de efeito grande (por exemplo, um aumento de 30% na conversão) atinge significância mais rapidamente e com amostras menores. Um tamanho de efeito minúsculo (por exemplo, 0,5%) requer amostras enormes para ser detectado de forma confiável.
É aqui que a relação entre significância estatística e significância prática se torna crítica. Uma descoberta pode ser estatisticamente significativa, mas praticamente irrelevante se o efeito for pequeno demais para importar nas decisões de negócios.
Qualidade dos Dados
Nenhum teste estatístico pode compensar dados ruins. Problemas comuns de qualidade de dados incluem:
- Viés de seleção: A amostra não representa a população-alvo.
- Erro de medição: A métrica sendo monitorada é não confiável ou inconsistente.
- Variáveis de confusão: Um fator não medido está gerando a diferença observada.
Antes de calcular a significância estatística, verifique se sua coleta de dados é limpa, consistente e livre de viés sistemático. Um resultado significativo a partir de dados falhos é pior do que nenhum resultado.
Poder Estatístico
O poder estatístico depende do tamanho da amostra, do tamanho do efeito e do nível de significância escolhido. Estudos com poder insuficiente são uma razão comum pela qual resultados aparentemente promissores de testes A/B falham ao serem replicados.
A Definição Central
Significância estatística é a probabilidade de que uma relação entre duas ou mais variáveis seja causada por algo além do acaso. Em termos formais, é a probabilidade de que uma diferença observada — ou uma mais extrema — ocorreria se a hipótese nula (a suposição de que não há efeito real) fosse verdadeira.
A estrutura vem do teste de hipóteses, um ramo da análise estatística desenvolvido no início do século XX por Ronald Fisher e refinado por Jerzy Neyman e Egon Pearson.
Significância Estatística vs. Acaso Aleatório
Todo conjunto de dados contém variação aleatória — a flutuação natural que ocorre mesmo quando não existe nenhum efeito subjacente. Jogue uma moeda honesta 100 vezes, e raramente você obterá exatamente 50 caras. Esse desvio é ruído aleatório, não evidência de que a moeda é tendenciosa.
A significância estatística quantifica se o desvio que você vê é grande o suficiente, em relação ao tamanho da sua amostra, para ser improvável apenas sob o ruído aleatório. Quando é, você pode rejeitar a hipótese nula e concluir que um efeito real provavelmente existe.
Dois conceitos relacionados ajudam aqui:
- Acaso aleatório: A probabilidade de que uma diferença observada surja puramente da variabilidade da amostragem.
- Variação aleatória (ou ruído aleatório): A imprevisibilidade inerente a qualquer processo de medição. Amostras maiores reduzem sua influência, tornando os efeitos reais mais fáceis de detectar.
Um Exemplo Simples do Mundo Real
Suponha que você administre uma loja online e teste duas versões de uma página de produto. A Versão A converte em 4,2%. A Versão B converte em 4,8%. Essa é uma diferença de 0,6 ponto percentual — mas será que é real?
Você executa um teste estatístico. Ele retorna um valor-p de 0,03.
Se o valor-p fosse 0,30, no entanto, a mesma diferença seria totalmente consistente com o acaso — e agir com base nela seria prematuro.
A Hipótese Nula e a Hipótese Alternativa
Todo teste de significância começa com duas afirmações concorrentes:
- Hipótese nula (H₀): Não há diferença ou relação real. Qualquer diferença observada é devida à variação aleatória.
- Hipótese alternativa (H₁): Há uma diferença ou relação real.
O teste não prova H₁ diretamente.
Essa estrutura se aplica diretamente aos testes A/B.
Entendendo os Valores-P
Interpretações equivocadas comuns a evitar:
- p = 0,03 NÃO significa que há 3% de chance de a hipótese nula ser verdadeira. Descreve a probabilidade dos dados sob a hipótese nula, não a probabilidade da hipótese nula dados os dados.
- p = 0,03 NÃO significa que o efeito tem 97% de chance de ser real. O valor-p não diz nada sobre a probabilidade de a hipótese alternativa estar correta.
- Um valor-p acima de 0,05 NÃO prova a hipótese nula. Significa que os dados não são surpreendentes o suficiente para rejeitá-la — o que é uma afirmação completamente diferente.
Níveis de Significância (Alpha)
O nível de significância, denotado α (alpha), é o limite que você define antes de executar um teste. Ele representa sua tolerância para falsos positivos — rejeitar a hipótese nula quando ela é realmente verdadeira. Isso também é chamado de erro Tipo I.
| Limiar | Significado | Risco de Falso Positivo |
|---|
| α = 0,05 | Padrão na maioria dos campos | — |
| α = 0,01 | Mais rigoroso; usado quando falsos positivos são custosos | — |
| α = 0,001 | Muito rigoroso; decisões de alto risco | — |
Se p < α, o resultado é estatisticamente significativo nesse nível.
Intervalos de Confiança Explicados
Um intervalo de confiança fornece uma faixa de valores plausíveis para o tamanho real do efeito. Um intervalo de confiança de 95% significa: se você repetisse o estudo 100 vezes, cerca de 95 desses intervalos conteriam o valor real.
Intervalos mais estreitos indicam estimativas mais precisas — tipicamente resultado de amostras maiores. Em contextos de negócios, os intervalos de confiança são frequentemente mais informativos do que os valores-p isoladamente, pois mostram a magnitude e a direção de um efeito, não apenas se ele existe.
A Convenção de 0,05
Sim — na maioria dos campos aplicados, p < 0,05 é o padrão para afirmar significância estatística. Essa convenção remonta ao trabalho de Ronald Fisher na década de 1920 e, embora um tanto arbitrária, persistiu porque equilibra dois riscos: falsos positivos (erros Tipo I) e falsos negativos (erros Tipo II, onde um efeito real é perdido).
0,01 vs. 0,05: Qual é Mais Significativo?
Um valor-p de 0,01 é mais significativo estatisticamente do que 0,05 porque indica uma probabilidade menor de que o resultado observado seja devido ao acaso. Em α = 0,01, você está aceitando apenas um risco de 1% de falso positivo, em comparação com 5% em α = 0,05.
No entanto, um valor-p menor não significa automaticamente um efeito maior ou mais importante. Com uma amostra enorme, mesmo uma diferença trivialmente pequena pode produzir p < 0,001. É por isso que o tamanho do efeito e a significância prática devem ser avaliados juntamente com o valor-p.
Quando p < 0,001
Um valor-p abaixo de 0,001 significa que o resultado observado ocorreria por acaso menos de 1 em 1.000 vezes se a hipótese nula fosse verdadeira. Isso é uma forte evidência contra a hipótese nula — mas ainda não garante importância prática.
Tamanho da Amostra
O tamanho da amostra é o fator mais influente. Amostras maiores reduzem o impacto da variação aleatória, tornando mais fácil detectar diferenças reais. É por isso que um aumento de 2% na conversão pode ser significativo com 50.000 visitantes, mas não com 500.
Para sites de baixo tráfego, isso significa que os testes devem ser executados por mais tempo ou focar em mudanças de efeito maior.
Tamanho do Efeito
O tamanho do efeito mede a magnitude da diferença observada — não apenas se ela existe. Um tamanho de efeito grande (por exemplo, um aumento de 30% na conversão) atinge significância mais rapidamente e com amostras menores. Um tamanho de efeito minúsculo (por exemplo, 0,5%) requer amostras enormes para ser detectado de forma confiável.
É aqui que a relação entre significância estatística e significância prática se torna crítica. Uma descoberta pode ser estatisticamente significativa, mas praticamente irrelevante se o efeito for pequeno demais para importar nas decisões de negócios.
Qualidade dos Dados
Nenhum teste estatístico pode compensar dados ruins. Problemas comuns de qualidade de dados incluem:
- Viés de seleção: A amostra não representa a população-alvo.
- Erro de medição: A métrica sendo monitorada é não confiável ou inconsistente.
- Variáveis de confusão: Um fator não medido está gerando a diferença observada.
Antes de calcular a significância estatística, verifique se sua coleta de dados é limpa, consistente e livre de viés sistemático. Um resultado significativo a partir de dados falhos é pior do que nenhum resultado.
Poder Estatístico
Poder estatístico é a probabilidade de que um teste detecte um efeito real quando ele existe. É o complemento da taxa de erro Tipo II (β).
O poder depende do tamanho da amostra, do tamanho do efeito e do nível de significância escolhido. Estudos com poder insuficiente são uma razão comum pela qual resultados aparentemente promissores de testes A/B falham ao serem replicados.
Como Calcular a Significância Estatística
Testes Estatísticos Comuns
Diferentes tipos de dados exigem diferentes testes:
| Teste | Caso de Uso | Exemplo |
|---|
| Teste T | Comparar médias de dois grupos | Taxas de conversão: Versão A vs. Versão B |
| Teste Qui-quadrado | Comparar frequências categóricas | Taxas de cliques em múltiplos criativos de anúncios |
| Teste Z | Comparar proporções com amostras grandes | Proporções de conversão de página de destino |
| ANOVA | Comparar médias entre três ou mais grupos | Desempenho entre múltiplos parceiros afiliados |
Usando Calculadoras e Ferramentas Online
Você não precisa calcular a significância estatística manualmente. Ferramentas amplamente utilizadas incluem:
- Plataformas de teste A/B (Optimizely, VWO, Google Optimize) — cálculos de significância integrados
- Calculadoras independentes (ferramentas de Evan Miller, AB Testguide) — gratuitas, baseadas na web
- Software estatístico (R, SciPy do Python, SPSS) — para análise personalizada
A maioria das ferramentas relata tanto o valor-p quanto o intervalo de confiança. Sempre verifique ambos antes de tomar uma decisão.
Fluxo de Trabalho Passo a Passo para Teste A/B
- Defina sua métrica: Escolha uma única métrica primária (taxa de conversão, taxa de cliques, receita por visitante).
- Calcule o tamanho de amostra necessário: Use uma calculadora de tamanho de amostra baseada em sua taxa de conversão inicial e no efeito mínimo detectável.
- Randomize e execute o teste: Divida o tráfego igualmente entre controle e tratamento. Não pare cedo.
- Analise os resultados: Compare o valor-p com α. Examine o intervalo de confiança para o tamanho do efeito.
- Decida: Se significativo e praticamente relevante, implemente a variação vencedora. Se não, documente a descoberta e teste outra coisa.
Significância Estatística no Marketing de Afiliados
A significância estatística não é apenas um conceito acadêmico. No marketing de afiliados, onde comissões, orçamentos e relacionamentos com parceiros dependem de dados de desempenho, é uma salvaguarda prática contra erros de julgamento custosos.
Para Anunciantes
Anunciantes que gerenciam programas de afiliados rotineiramente testam páginas de destino, estruturas de ofertas e ativos criativos. A significância estatística garante que as decisões sobre qual versão escalar sejam baseadas em diferenças reais de desempenho, e não em flutuações aleatórias.
Exemplo de fluxo: Um anunciante testa duas estruturas de comissão — uma taxa fixa de 10% vs. um modelo escalonado de 5%/12%/18%. Após 30 dias e 5.000 transações, o modelo escalonado mostra um valor médio de pedido 22% maior. Um teste T retorna p = 0,02. O anunciante pode implementar com confiança a estrutura escalonada, sabendo que a diferença observada dificilmente é ruído aleatório.
Sem o teste de significância, o anunciante poderia ter feito a mudança com base em uma flutuação de curto prazo — e potencialmente reduzido os ganhos dos parceiros se o efeito se invertesse.
Para Editores
Editores (afiliados) tomam decisões sobre quais produtos promover, em quais fontes de tráfego investir e quais formatos de conteúdo convertem melhor. Cada uma dessas decisões se beneficia do teste de significância.
Exemplo de fluxo: Um editor testa duas versões de um artigo de avaliação — uma com a tabela comparativa no topo, outra com ela no final. Em 10.000 visualizações de página, a versão com posicionamento no topo gera uma taxa de cliques de 3,1% para o comerciante vs. 2,6% para o posicionamento no final. Um teste qui-quadrado dá p = 0,04. O editor adota o formato com posicionamento no topo e aplica o padrão a outras avaliações.
Para Gerentes de Programa de Afiliados
Gerentes de programa avaliam o desempenho dos parceiros, definem faixas de comissão e decidem quais afiliados recrutar ou reter. A significância estatística ajuda a distinguir consistentes de alto desempenho daqueles cujos meses fortes são apenas variância.
Exemplo de fluxo: Um gerente de programa compara dois afiliados com volumes de tráfego semelhantes. O Afiliado A tem uma taxa de conversão de 5,2% em 12 meses; o Afiliado B tem 4,1%. Um teste Z de duas amostras confirma que a diferença é significativa (p = 0,008). O gerente usa esses dados para alocar comissões de nível mais alto ao Afiliado A e investigar o que o Afiliado B poderia melhorar.
Em todas as três funções, o princípio é o mesmo: deixe os dados atingirem significância antes de agir. Decisões prematuras — aumentar comissões para um parceiro que teve um bom mês, ou abandonar uma página de destino que teve uma semana ruim — estão entre os erros mais comuns e evitáveis no marketing de afiliados.
Limitações e Equívocos Comuns
Significativo ≠ Importante
Este é o equívoco mais persistente. Um resultado pode ser estatisticamente significativo com p < 0,001 e ainda assim ser pequeno demais para importar. Em um exemplo conhecido do manual de estatística de engenharia do NIST, uma melhoria de processo de fabricação foi estatisticamente significativa, mas produziu um ganho de apenas 0,2 unidades — muito abaixo do limiar de valor prático.
Sempre faça duas perguntas:
- É estatisticamente significativo? (o valor-p)
- O efeito é grande o suficiente para importar? (o tamanho do efeito)
P-Hacking e a Crise de Reprodutibilidade
P-hacking refere-se à prática de executar múltiplas análises e relatar seletivamente apenas aquelas que atingem significância. Formas comuns incluem:
- Testar muitas métricas e destacar aquela que “vence”
- Parar a coleta de dados quando p cruza 0,05
- Excluir outliers post hoc para reduzir o valor-p
Essas práticas inflam dramaticamente as taxas de falso positivo.
A lição para usuários de negócios: pré-registre seu plano de teste, mantenha-se em uma única métrica primária e resista à tentação de pescar significância.
Quando Não Confiar na Significância Estatística
A significância estatística é menos útil — ou diretamente enganosa — nestes cenários:
- Amostras muito pequenas: Com menos de 100 observações por grupo, apenas efeitos enormes atingirão significância. Resultados negativos não são informativos, não são evidência de ausência de efeito.
- Múltiplas mudanças simultâneas: Se você alterar cinco elementos de uma página de uma vez, um resultado significativo não pode dizer qual mudança gerou o efeito.
- Trabalho exploratório de baixo risco: Nem toda decisão exige teste formal de significância. Para exploração em estágio inicial, dados direcionais podem ser suficientes.